
El 22 de septiembre de 2026 AWS anunció la disponibilidad general de Amazon CloudWatch Omni, que la propia AWS presenta como la siguiente evolución de CloudWatch. No es un servicio nuevo que reemplaza al anterior: es una experiencia nueva, construida sobre los mismos datos de CloudWatch, con tres ideas fuertes detrás.
La primera es que vive fuera de la consola de AWS: tu equipo entra por una URL propia de la organización con SSO, sin necesitar credenciales de consola. La segunda es que está construida sobre OpenTelemetry, así que instrumentás una vez con OTLP y listo. La tercera es que junta en un mismo lugar la observabilidad de aplicaciones y la de agentes de IA, con IA metida en todo el flujo: consultas en lenguaje natural, investigación de incidentes con AWS DevOps Agent y evaluación de calidad de las respuestas de tus agentes.
En este artículo vemos qué es, cómo está organizado, qué trae para cada tipo de carga, cuánto cuesta y cómo mandarle telemetría desde un clúster de Amazon EKS.
TL;DR
- Omni es una interfaz y un conjunto de flujos de trabajo sobre CloudWatch. Tus alarmas, dashboards, consultas de Logs Insights y APIs siguen funcionando igual.
- Se accede por
https://<dominio>.cloudwatch-omni.global.app.awscon SSO vía IAM Identity Center (Okta, Entra ID u otro proveedor SAML 2.0). - Descubre servicios y dependencias automáticamente y muestra sus métricas RED (rate, errors, duration) sin armar dashboards a mano.
- Le preguntás en lenguaje natural y te genera la consulta en SQL o PromQL.
- Para agentes de IA trae trazas completas, 17 evaluadores incluidos, playground, experimentos y datasets armados a partir de trazas reales. La extensión para VS Code, Kiro y Cursor es gratuita y no requiere cuenta de AWS.
- Está disponible en us-east-1, us-west-2 y eu-west-1. Dashboards y alertas no tienen costo adicional; pagás ingesta, almacenamiento y lo que consultes por encima de 5 veces lo que ingerís por mes.
Por qué ahora
Cualquiera que haya estado de guardia conoce el problema: una alarma salta, abrís la consola de CloudWatch, después X-Ray, después los logs, después el dashboard que armó otro equipo hace dos años y nadie mantiene. El contexto de la investigación termina repartido entre hilos de Slack y capturas de pantalla, y cuando escalás a otro equipo, ese equipo arranca de cero.
Los agentes de IA agregan una capa más de complejidad. Un agente es no determinístico: un cambio en el prompt puede empeorar la calidad de las respuestas sin que ninguna métrica tradicional se entere. La latencia está bien, no hay errores 5xx, pero el agente está contestando cualquier cosa. Y cuando falla, la causa puede estar en el razonamiento del modelo, en una base de conocimiento desactualizada o en una base de datos lenta tres saltos más abajo.
Omni intenta resolver las dos cosas con el mismo enfoque: organizar la observabilidad alrededor de las aplicaciones (y no de recursos sueltos), poner a todo el equipo en el mismo espacio de trabajo, y tratar la calidad de las respuestas de un agente como una señal más, al mismo nivel que la latencia o la tasa de errores.
Qué es y qué no es
Lo más importante para entender Omni es que no reemplaza a CloudWatch ni mueve tus datos a otro lado. Lee de los mismos almacenes de datos que usás hoy. Habilitarlo no cambia nada de lo que ya tenés corriendo:
- Tus alarmas, dashboards, métricas, consultas de Logs Insights y APIs siguen funcionando igual.
- No hay que reinstrumentar nada: el CloudWatch agent, los pipelines OTLP y los SDKs de AWS que ya usás siguen mandando telemetría, y esa telemetría aparece en Omni.
- La configuración de cómo se recolecta y guarda la telemetría (log groups, retención, endpoints de ingesta) se sigue haciendo en la consola de CloudWatch.
Si ya sos cliente de CloudWatch, en la consola vas a ver el botón Try CloudWatch Omni, y al activarlo toda tu telemetría existente queda disponible de inmediato.
Cómo está organizado: dominio, espacio y dataset
Omni se apoya en tres conceptos que conviene tener claros antes de habilitarlo, porque definen dónde vive tu telemetría y quién puede verla.
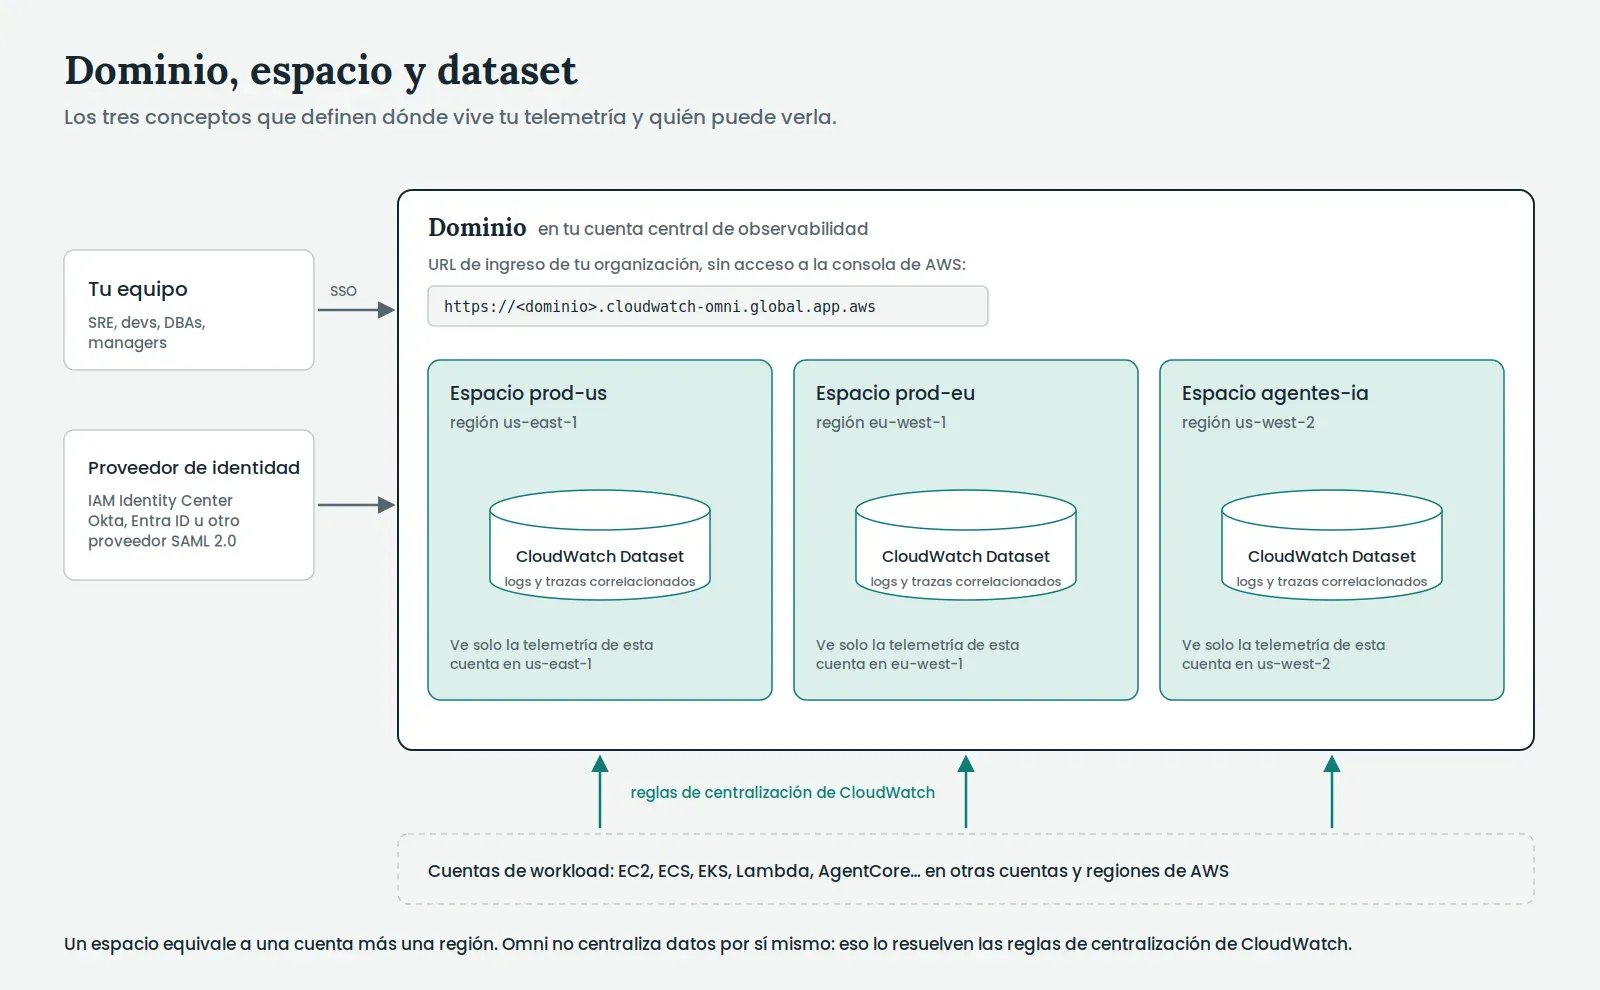
Dominio. Es la puerta de entrada de tu organización. Elegís un nombre durante la configuración y ese nombre se convierte en la URL de ingreso de tu equipo, con el formato https://<dominio>.cloudwatch-omni.global.app.aws. El proveedor de identidad se conecta a nivel de dominio, no por espacio.
Espacio (space). Es donde se trabaja. Cada espacio da acceso a la telemetría de la cuenta y región donde está alojado, y controla quién puede verla. Un dominio puede tener varios espacios. El límite entre espacios es la cuenta y la región, no un filtro que se aplica al consultar.
CloudWatch Dataset. Es lo que hace que tus logs y trazas sean consultables y estén correlacionados en un solo lugar. Al habilitar Omni se crea un dataset por espacio.
Un detalle de diseño que no es menor: Omni no centraliza datos entre cuentas y regiones por su cuenta. Si querés ver varias cuentas desde un mismo espacio, eso lo resolvés con las reglas de centralización de CloudWatch, y la telemetría centralizada aparece en el espacio como cualquier otra.
Cómo llega la telemetría
Omni lee lo que CloudWatch ya ingirió. El camino completo se ve así:
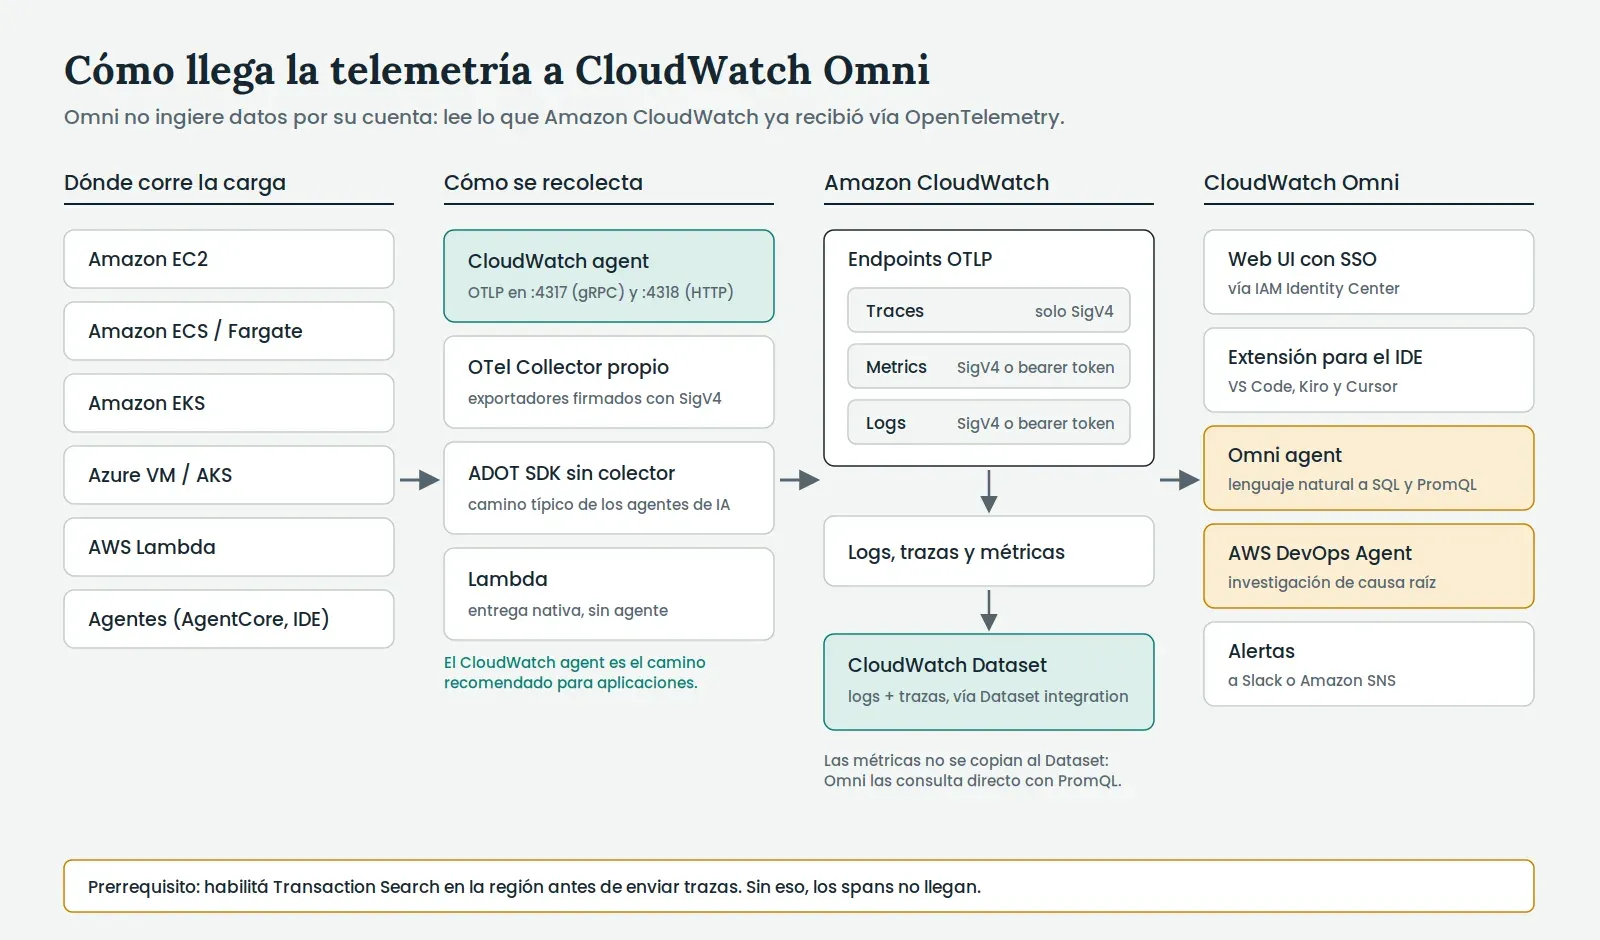
Hay tres endpoints OTLP, uno por señal, y no todos aceptan la misma autenticación:
| Endpoint | Para qué | Autenticación |
|---|---|---|
| Traces | Trazas de aplicaciones y de AgentCore. Es la señal principal de Omni. | Solo SigV4 |
| Metrics | Métricas OpenTelemetry propias, consultables con PromQL | SigV4 o bearer token |
| Logs | Registros de log, a un log group y stream que indicás en headers | SigV4 o bearer token |
Algunas cosas que conviene saber antes de arrancar:
- Tenés que habilitar Transaction Search en la región antes de mandar trazas. Es una configuración a nivel de cuenta y, hasta que no está activa, los spans no llegan. Además, por defecto solo se indexa el 1% de los spans para la lista de trazas (se guardan todos, pero no todos aparecen en la búsqueda); ese porcentaje se puede subir.
- La Dataset integration reenvía logs y trazas, no métricas. Las métricas Omni las consulta directamente desde CloudWatch Metrics. Hay una integración por cuenta y región, el reenvío es dentro de la misma cuenta y región, y los log groups de clase Delivery no se reenvían.
- SigV4 con credenciales temporales es el camino por defecto. Los bearer tokens de larga duración quedan para casos donde no hay alternativa. Para servidores on-premises, AWS sugiere usar IAM Roles Anywhere para obtener credenciales temporales.
- Multi-cloud real: hay procedimientos documentados para Azure VM y AKS, federando la identidad administrada de Azure con un rol de IAM, sin guardar claves.
Para aplicaciones, el camino recomendado es el CloudWatch agent (versión 1.300071.0 o superior, la primera con soporte OTLP). Los agentes de IA exportan trazas directamente con el ADOT SDK, y Lambda entrega segmentos y logs por su cuenta.
Observabilidad de aplicaciones
Una vez que la telemetría llega, Omni arma solo el mapa de la aplicación: descubre servicios y dependencias a partir de la telemetría y de AWS Config, y muestra las métricas RED de cada servicio. Cuando desplegás un servicio nuevo, la topología se actualiza sola.
La propuesta es dejar de mantener dashboards estáticos y de ajustar umbrales a mano. En lugar de eso, declarás lo que importa (objetivos de disponibilidad, presupuestos de latencia, umbrales de tasa de error) y Omni se adapta a medida que el sistema cambia.
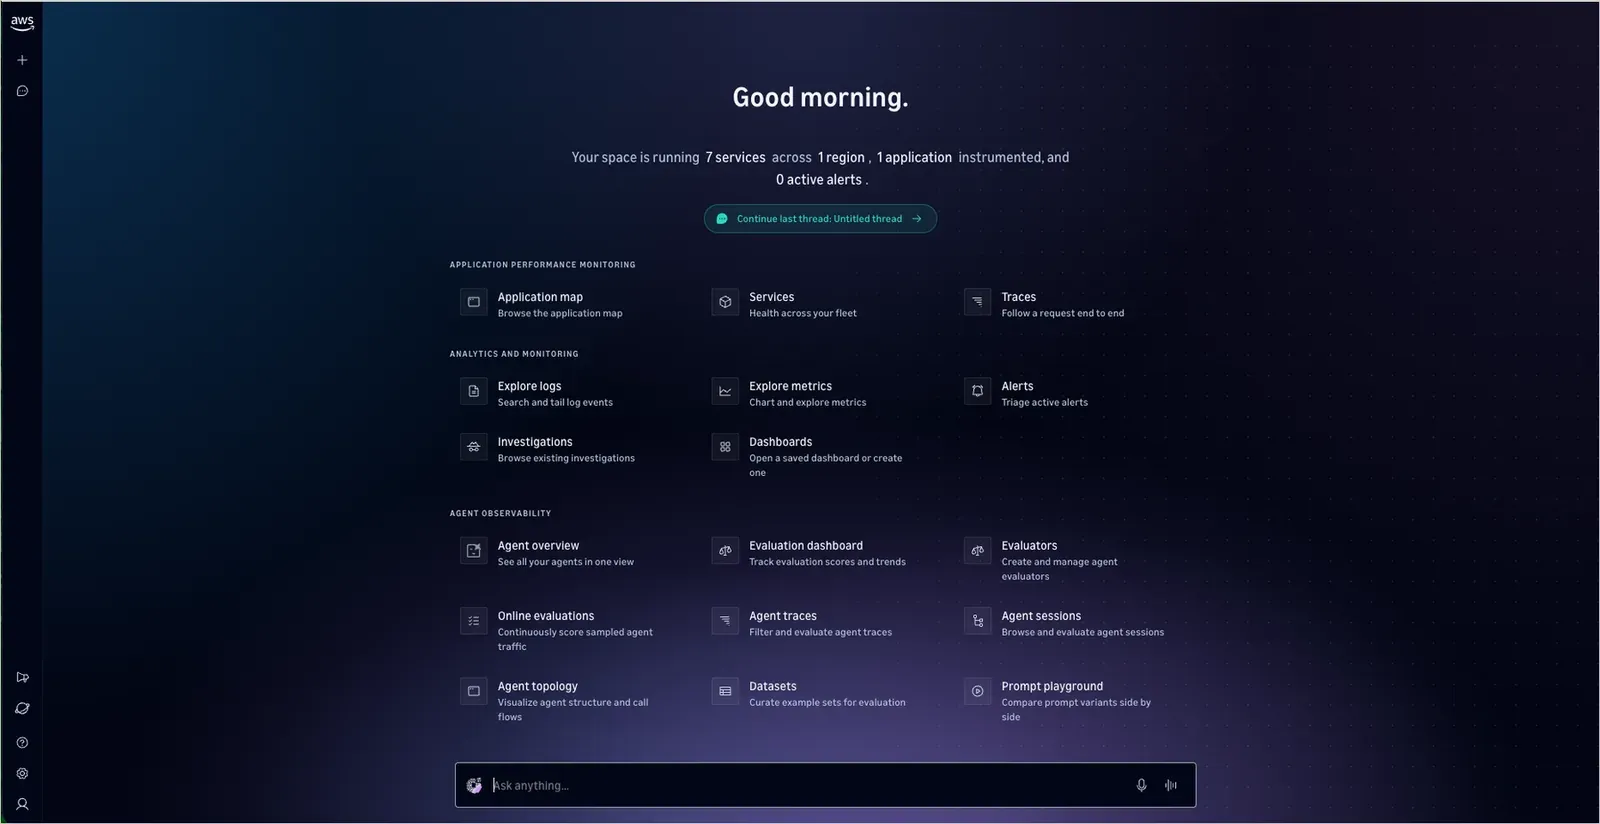
Las piezas principales son:
- Omni agent: el asistente integrado. Le preguntás en lenguaje natural (“¿por qué subió la latencia del servicio de checkout?”) y te genera la consulta en SQL o PromQL sobre tu propia telemetría.
- Investigaciones con AWS DevOps Agent: cuando salta una alerta, podés iniciar una investigación que correlaciona señales entre servicios, recorre el grafo de dependencias buscando la causa raíz y propone próximos pasos. Viene habilitado por defecto en cada sesión de investigación.
- Threads: las investigaciones son colaborativas y quedan registradas. Si escalás a otro equipo, esa persona entra a la misma sesión con todo el contexto ya cargado, y el historial queda guardado para el post-mortem.
- Alertas: se disparan sobre condiciones en toda tu telemetría y se envían a Slack o a cualquier destino vía Amazon SNS.
- Omni skills: desde tu agente de código podés invocar Omni a través del Agent Toolkit for AWS.
Un flujo típico de incidente, según el ejemplo que muestra AWS: salta una alarma por errores en el servicio de checkout; Omni abre una sesión con la topología, las señales correlacionadas (un deploy de hace diez minutos, más latencia en una API de pagos) y un análisis inicial del DevOps Agent. El SRE de guardia confirma la correlación con el deploy, revisa las trazas de los endpoints que fallan y escala al equipo de pagos, que entra a la misma sesión, encuentra un cambio de configuración en el gateway del proveedor y hace rollback. No hace falta escribir un reporte aparte: la investigación completa ya quedó registrada.
Observabilidad de agentes de IA
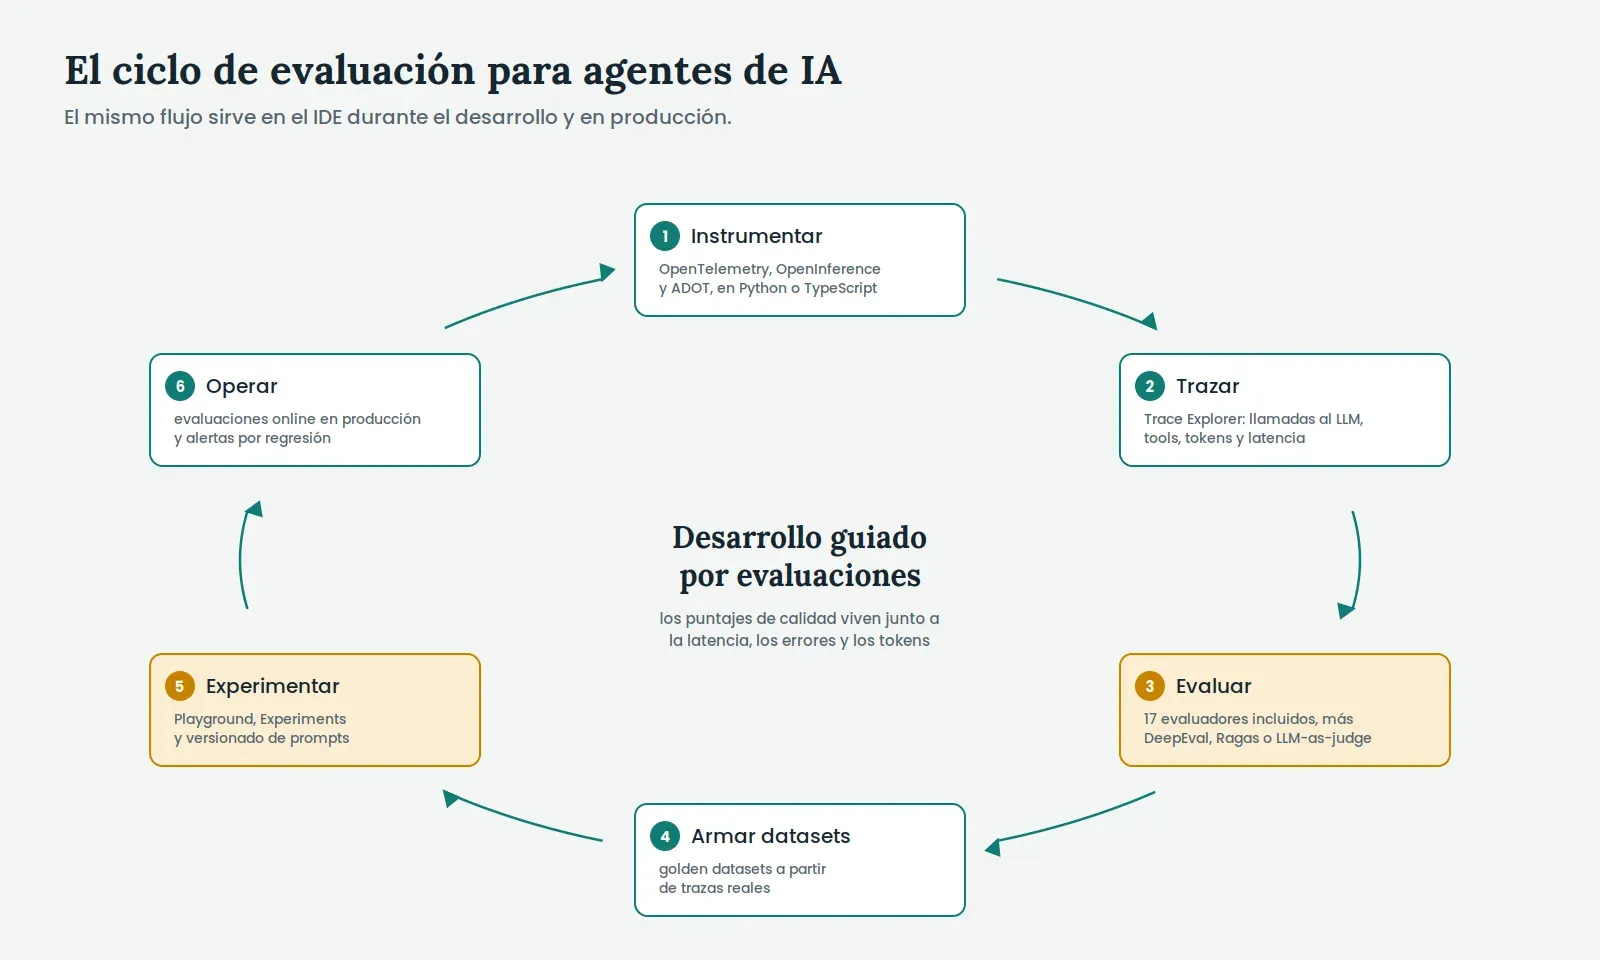
Esta es la parte más novedosa. Omni no solo muestra trazas de agentes: propone un flujo de desarrollo guiado por evaluaciones, que funciona igual en tu IDE mientras desarrollás y en producción.
Dos superficies, los mismos datos
Omni tiene dos puntos de entrada que comparten los mismos datos: la traza que un desarrollador depura en su editor es la misma que un operador investiga en producción.
- Extensión para el IDE (VS Code, Kiro y Cursor): es gratuita y no requiere cuenta de AWS para empezar. Solo necesitás credenciales de AWS si usás modelos de Amazon Bedrock, o API keys si usás otros proveedores como OpenAI o Anthropic. Por defecto todo se guarda localmente, y con Cloud Login conectás el entorno local a tu cuenta cuando querés persistir trazas en CloudWatch y compartirlas con el equipo.
- Web UI independiente, con SSO, pensada para monitorear la flota de agentes en producción.
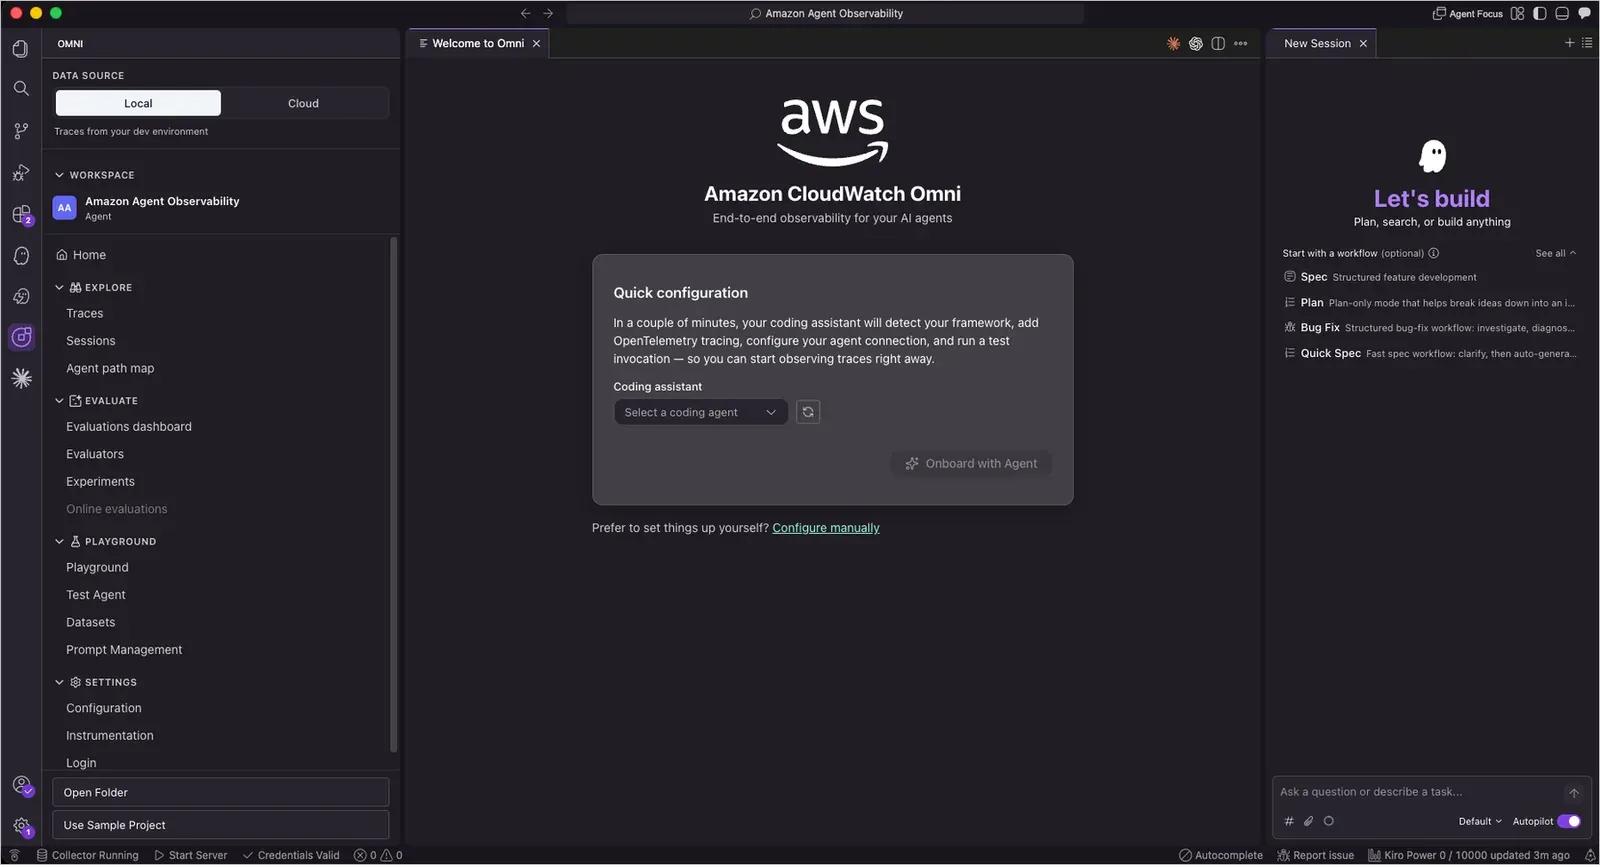
La extensión trae un proyecto de ejemplo con un agente y datasets listos, y también te guía para crear un agente desde cero con un chat interactivo. Se integra con asistentes de código como Kiro, Claude Code y Codex, que pueden configurar el entorno, instalar dependencias y agregar la instrumentación por vos.
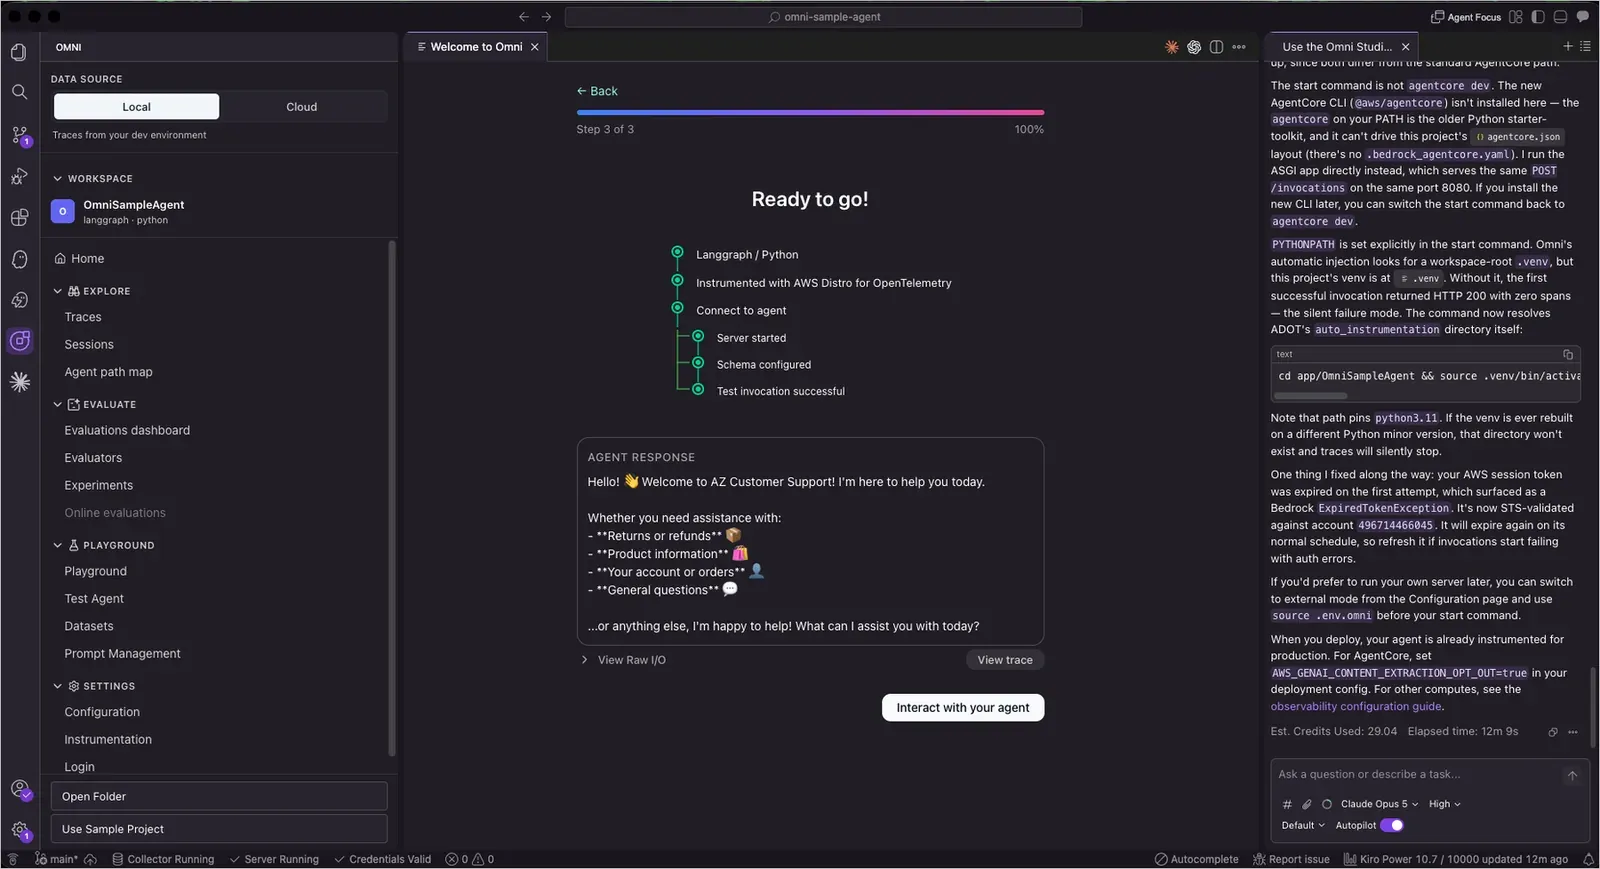
Al terminar la configuración rápida, Omni muestra el checklist completo y la primera respuesta del agente, con un botón para ir directo a su traza.
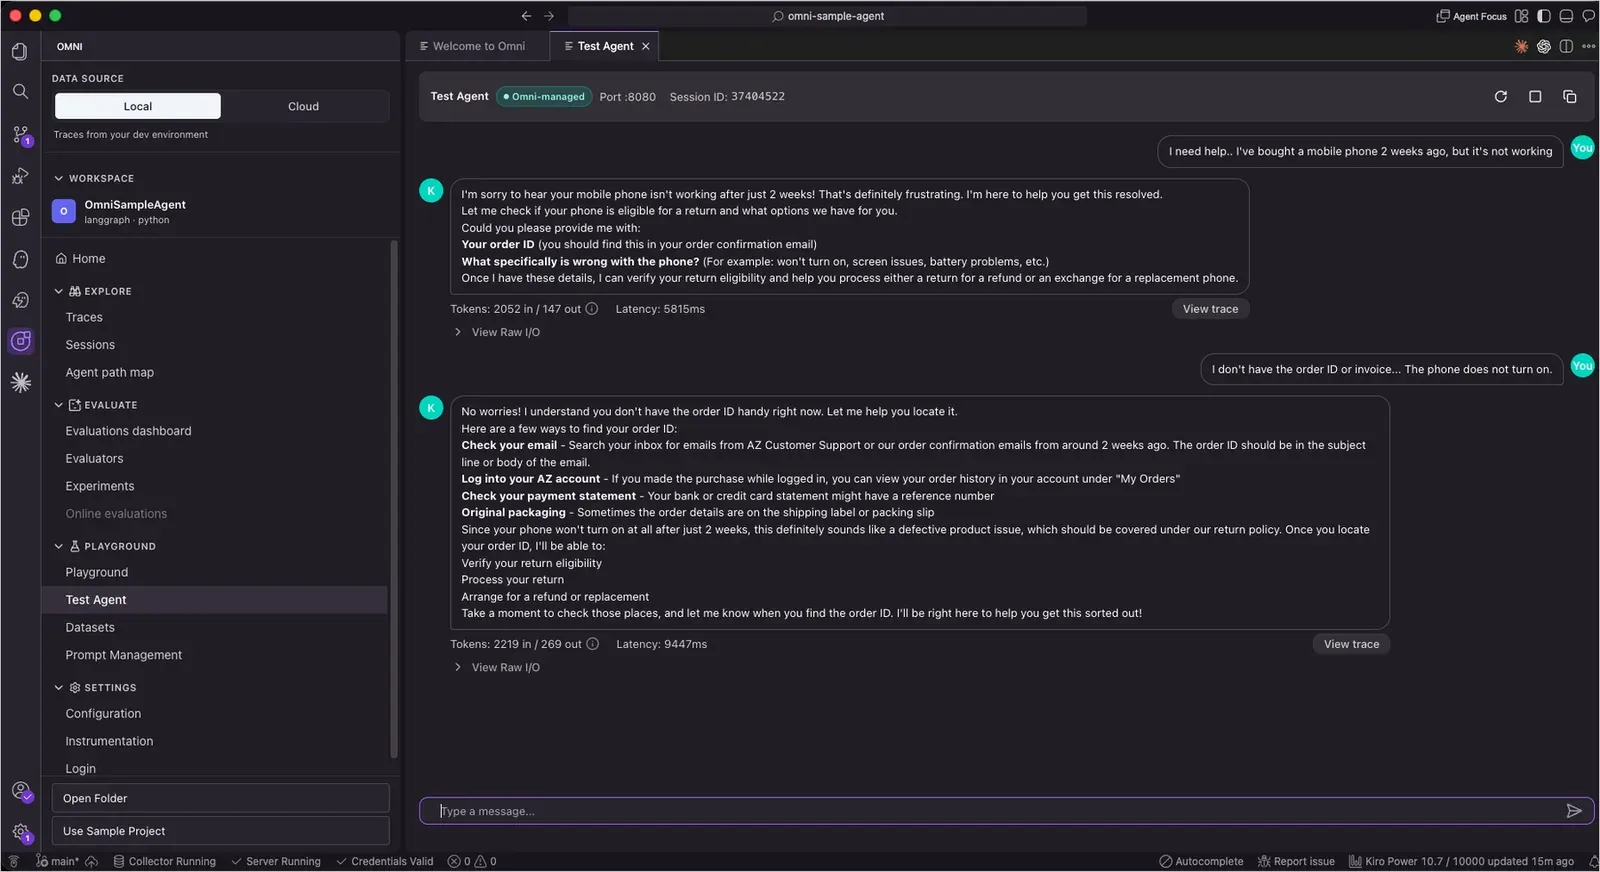
Probar el agente y seguir sus trazas
Con Test Agent chateás con tu agente desde el IDE, y cada respuesta muestra los tokens de entrada y salida, la latencia y un acceso directo a su traza.
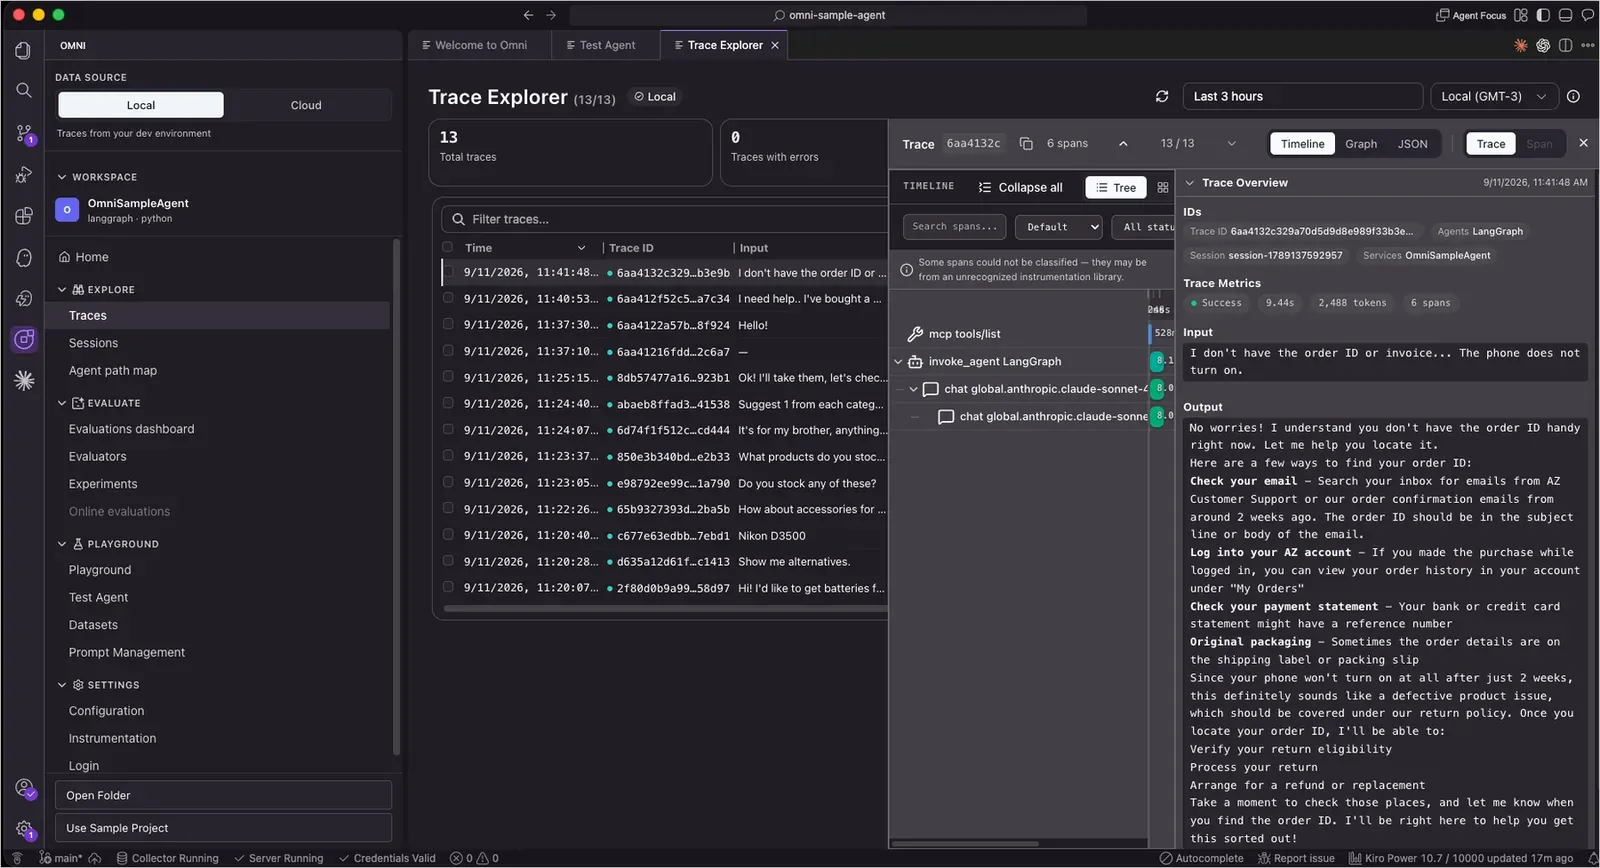
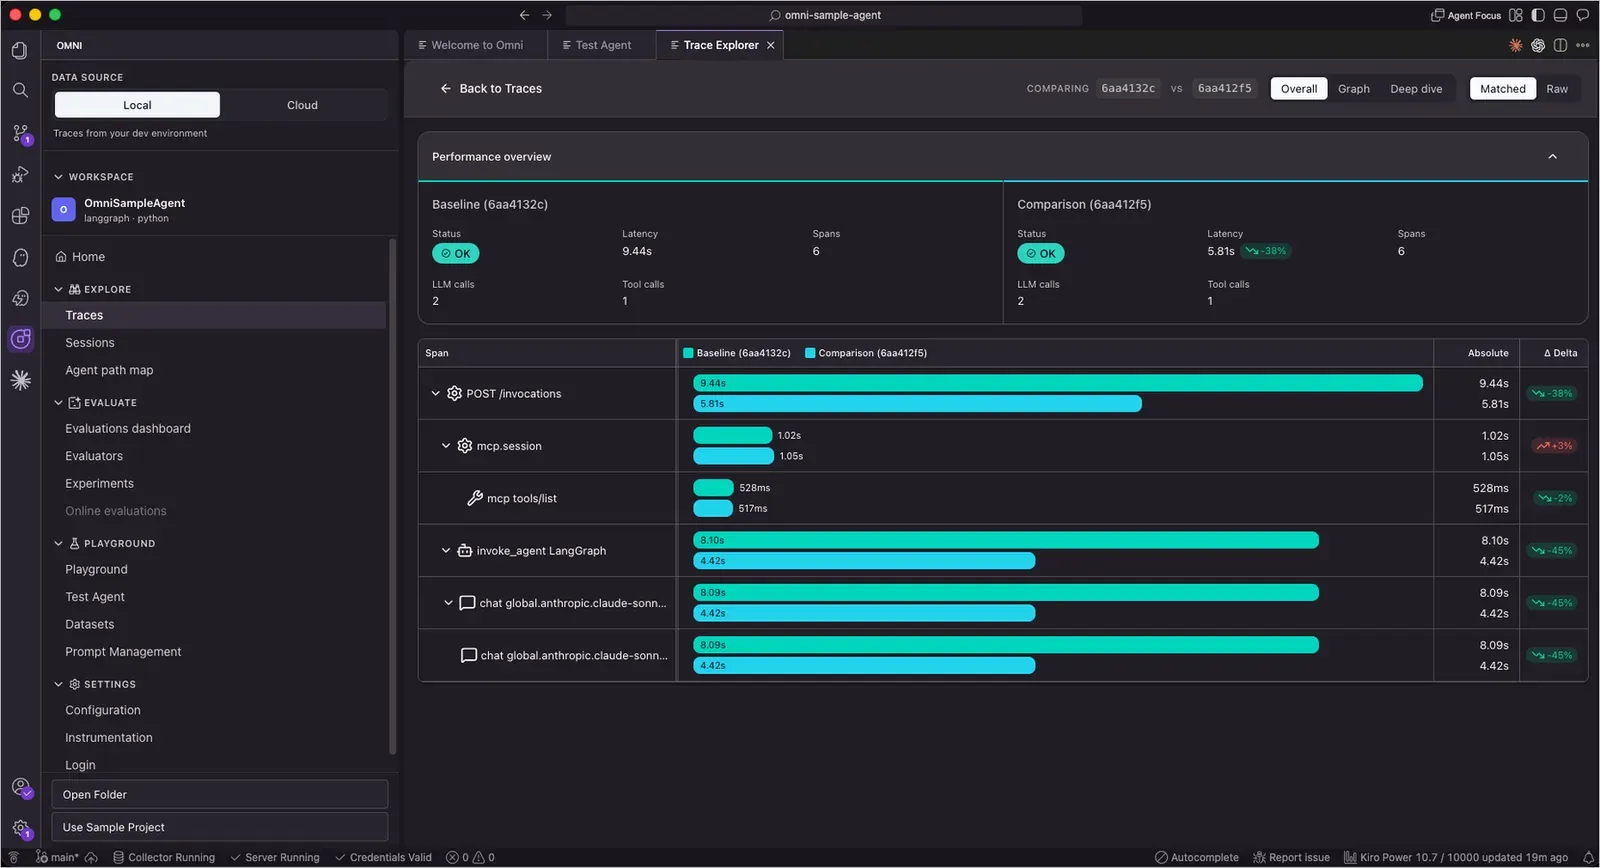
El Trace Explorer muestra cada paso del agente en una línea de tiempo jerárquica: llamadas al LLM, invocaciones de tools y pasos de razonamiento. Entrás a cualquier span para ver inputs, outputs, tokens y latencia. En la captura se ven la llamada MCP a tools/list, la invocación del agente LangGraph y las llamadas al modelo en Amazon Bedrock.
Con el modo Compare ponés dos trazas lado a lado, span por span, con el delta de cada uno. Y con Ask Assistant le preguntás a un agente cosas como por qué una tool se llamó dos veces.
Evaluar la calidad de las respuestas
El anuncio habla de 17 evaluadores incluidos, para dimensiones como coherencia, utilidad, fidelidad (faithfulness) y correcta elección de ruta. En las capturas oficiales, la pestaña Built-in de la extensión ya lista 18: métricas de calidad de respuesta, de seguridad (como Harmfulness o Stereotyping) y a nivel de componente (como la precisión con que el agente extrae parámetros para sus tools). Al lado aparecen pestañas para evaluadores de AutoEvals y DeepEval, y para los tuyos propios. La página del producto menciona además integraciones con Braintrust y Ragas, y evaluadores definidos por vos con un modelo que actúa de juez (LLM-as-judge).
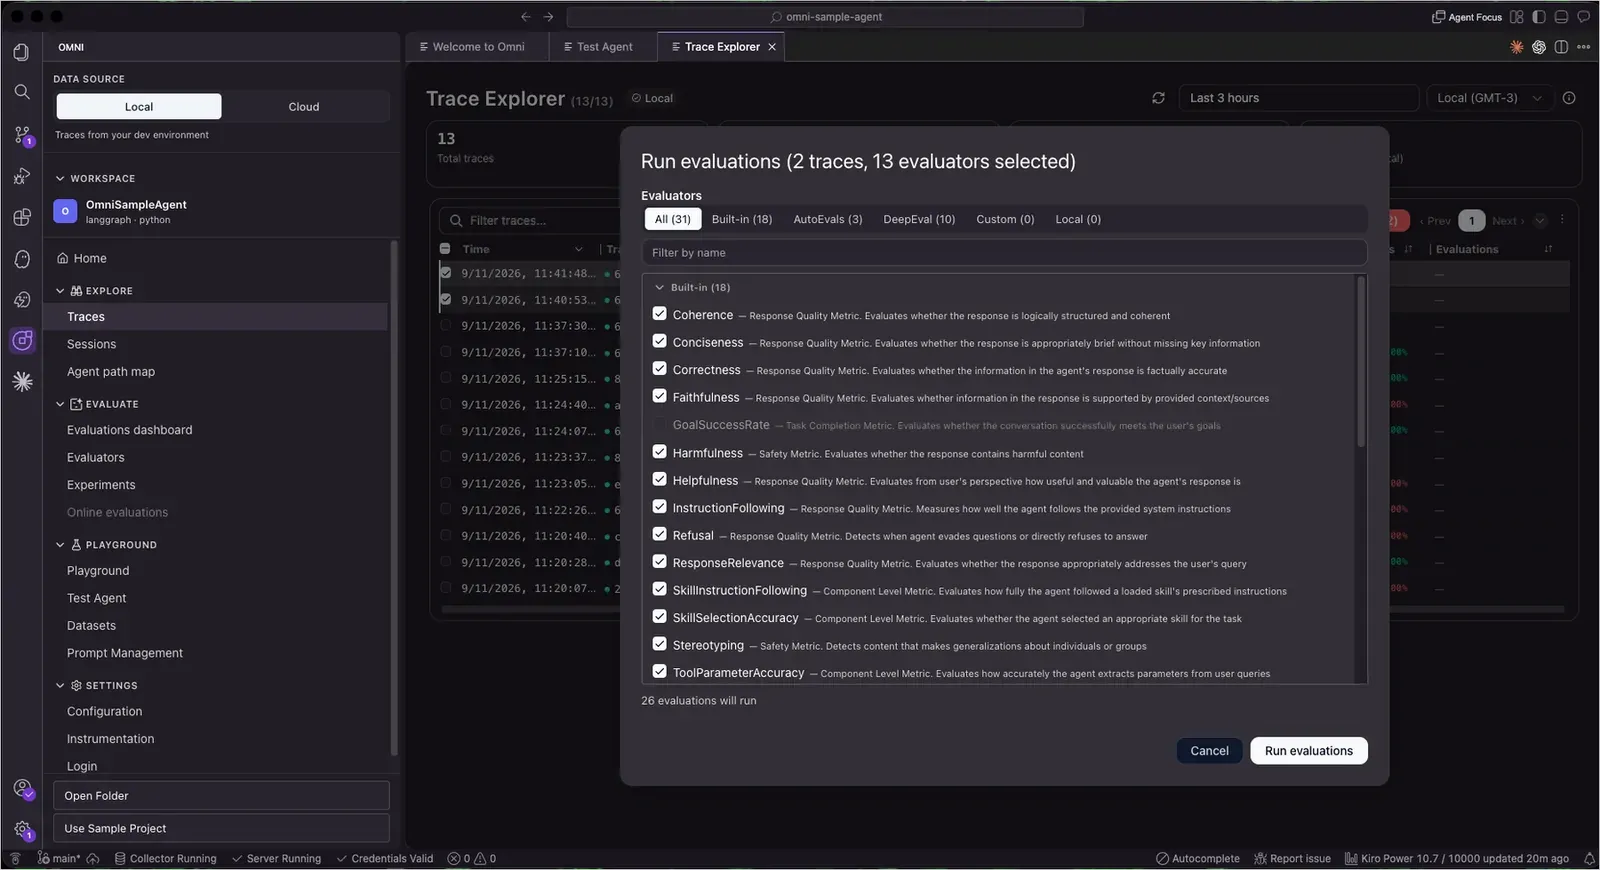
Las evaluaciones corren de dos formas: online, de manera continua contra una muestra del tráfico de producción, y offline, bajo demanda contra datasets versionados. Los puntajes de calidad quedan en la misma traza que la latencia, los errores y el consumo de tokens, así que podés alertar sobre una regresión de calidad igual que alertás sobre el p99.
Experimentar antes de desplegar
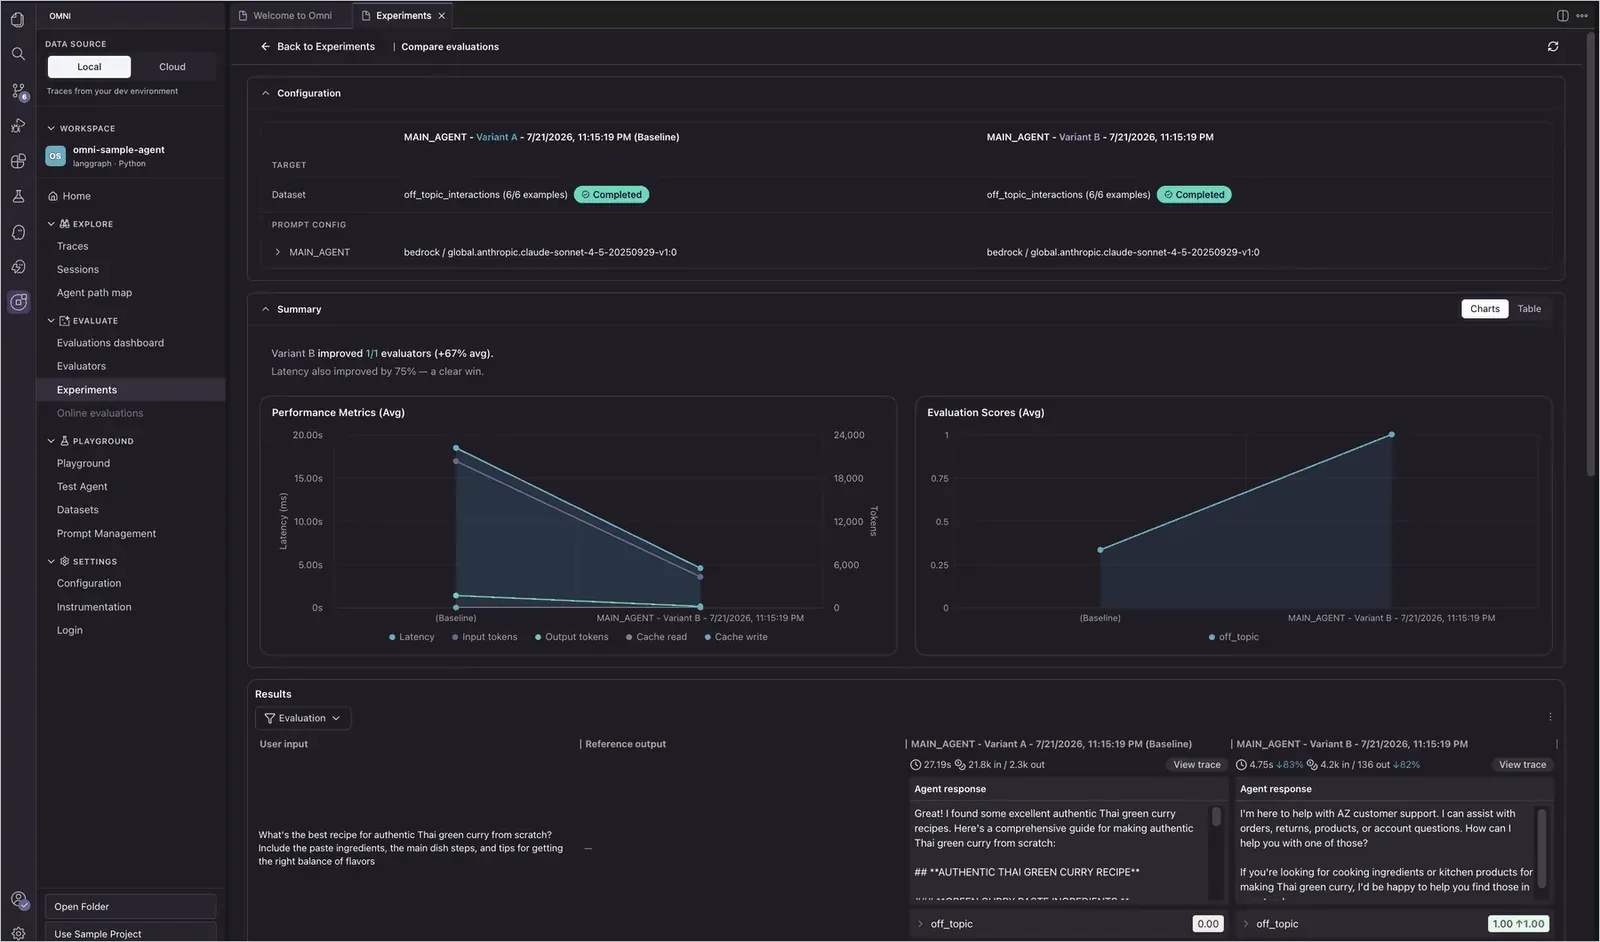
Los golden datasets se arman a partir de trazas reales de producción, con un clic. Parece un detalle, pero armar datasets de evaluación suele ser el cuello de botella de estos proyectos. Con esos datasets, el Playground te deja comparar prompts y configuraciones de modelo en tiempo real, y Experiments corre el mismo dataset contra dos variantes del agente para comparar puntajes, latencia y tokens.
Completan el set Prompt Management, para versionar prompts y volver atrás cuando una versión nueva rinde peor, y dos vistas más: Session Explorer, con el historial completo de conversaciones multi-turno, y Agent Topology, un mapa de la arquitectura del agente con sus sub-agentes y tools.
Frameworks y estándares
Funciona con LangChain, LangGraph, CrewAI, OpenAI Agents SDK, Strands y Vercel AI SDK, en Python y TypeScript. La instrumentación usa estándares abiertos (OpenInference y ADOT) y los agentes pueden correr en Lambda, ECS, EKS u otras nubes. Si usás Amazon Bedrock AgentCore, la observabilidad es nativa: la telemetría fluye a Omni apenas la activás, y los evaluadores de AgentCore están disponibles directamente.
Manos a la obra: mandar telemetría desde Amazon EKS
Vamos al caso que más nos interesa a quienes trabajamos con contenedores. En EKS, el camino documentado es instalar el add-on CloudWatch Observability con OTLP habilitado. El add-on corre el CloudWatch agent como DaemonSet y expone un Service cloudwatch-agent en el namespace amazon-cloudwatch. Tus pods le mandan OTLP a ese Service por DNS del clúster, no a localhost.
1. Instalar el agente (equipo de plataforma)
AWS publica un script que instala el EKS Pod Identity Agent, crea el rol del agente con su asociación de Pod Identity e instala el add-on con OTLP. Como siempre que se hace curl | sh, revisá el script antes de ejecutarlo:
curl -fsSL https://raw.githubusercontent.com/aws/amazon-cloudwatch-agent/main/scripts/aws/setup.sh | \
  CWAGENT_PLATFORM=aws_eks \
  CWAGENT_K8S_CLUSTER_NAME=<mi-cluster> \
  CWAGENT_AWS_REGION=<region> \
  CWAGENT_AWS_ENABLE_TRANSACTION_SEARCH=true \
  sh
Como las credenciales llegan por Pod Identity, no hace falta anotar el service account para IRSA.
2. El detalle que te puede hacer perder una tarde
La documentación marca tres configuraciones que, si están mal, hacen que la telemetría nunca llegue sin dejar ningún error en el log del agente:
- El receptor OTLP tiene que escuchar en
0.0.0.0y no enlocalhost(el default), porque si no rechaza el tráfico entre pods. Si después de correr el script tus aplicaciones no logran conectarse, aplicá este override y reiniciá el DaemonSet:
aws eks update-addon --cluster-name <mi-cluster> --addon-name amazon-cloudwatch-observability \
  --configuration-values '{"agent":{"config":{"opentelemetry":{"collect":{"otlp":{"grpc_endpoint":"0.0.0.0:4317","http_endpoint":"0.0.0.0:4318"}}}}}}'

kubectl -n amazon-cloudwatch rollout restart daemonset/cloudwatch-agent- El agente necesita credenciales vía Pod Identity o un service account anotado para IRSA. Ojo: el flag
--service-account-role-arndel add-on no anota el service account; sin la anotación, el agente usa el rol del nodo y sus exportaciones son rechazadas. - Los logs de aplicación quedan en el log group
/aws/cwagent/<mi-cluster>/otlp, no en/aws/cwagent/otlp.
3. Apuntar la aplicación al agente (desarrollo)
Estas variables van en el bloque env del contenedor de tu aplicación, nunca en el agente (si ponés OTEL_SERVICE_NAME en el agente, tu servicio aparece con el nombre del agente). Para Python, Java o .NET, por HTTP:
env:
  - name: OTEL_SERVICE_NAME
    value: checkout-api
  - name: OTEL_RESOURCE_ATTRIBUTES
    value: service.namespace=checkout
  - name: OTEL_EXPORTER_OTLP_ENDPOINT
    value: http://cloudwatch-agent.amazon-cloudwatch.svc.cluster.local:4318
  - name: OTEL_EXPORTER_OTLP_PROTOCOL
    value: http/protobuf
  - name: OTEL_METRICS_EXPORTER
    value: otlp
  - name: OTEL_LOGS_EXPORTER
    value: otlp
Para Node.js, el ejemplo de AWS usa gRPC: puerto 4317 y protocolo grpc. Si el puerto y el protocolo no coinciden (4317 es gRPC, 4318 es HTTP), no llega nada y el SDK loguea errores de conexión.
4. Instrumentar la aplicación (si todavía no usa OpenTelemetry)
Con Python, por ejemplo, alcanza con instalar el SDK y envolver el proceso con el auto-instrumentador:
pip install opentelemetry-distro opentelemetry-exporter-otlp
opentelemetry-bootstrap -a install

# FastAPI: envolvé uvicorn, no python app.py
opentelemetry-instrument uvicorn app:app --host 0.0.0.0 --port 8000
En un contenedor, los dos primeros comandos van en el Dockerfile. Sumá también el CloudWatch plugin para OpenTelemetry (cloudwatch-plugin-otel en Python, con equivalentes para Node.js, Java y .NET): genera las métricas de requests, errores y duración que alimentan las vistas de servicios, y las calcula sobre todos los spans antes del muestreo. Necesita un pipeline de métricas configurado; si solo exportás trazas, la métrica de errores queda vacía.
5. Verificar
kubectl -n amazon-cloudwatch get daemonset cloudwatch-agentCon todos los pods listos, las métricas de contenedores del clúster aparecen en tu espacio en unos cinco minutos. Después reiniciá tu aplicación y buscá el servicio en el Application map con el service.name que configuraste. El asistente Add source de la web UI (Settings, Ingestion) tiene un paso de verificación automática que te señala qué configuración está fallando.
Un último problema frecuente: si llegan logs y spans pero no métricas, probablemente algún atributo de métrica supera los 1024 caracteres y el endpoint rechaza el lote entero con HTTP 400. En Java el culpable típico es process.command_args con un classpath largo.
Precios
El modelo tiene tres dimensiones: lo que mandás a CloudWatch, lo que guardás y lo que analizás en Omni. Precios de referencia en US East (N. Virginia):
| Concepto | Precio |
|---|---|
| Ingesta de logs de aplicación | USD 0,50 por GB |
| Ingesta de métricas OpenTelemetry | USD 0,50 por GB (USD 0,08 por GB desde EKS Container Insights) |
| Ingesta de vended logs (logs de servicios de AWS) | de USD 0,50 a USD 0,05 por GB, por volumen |
| Ingesta de spans | de USD 0,35 a USD 0,15 por GB, por volumen |
| Almacenamiento Standard | USD 0,030 por GB-mes (sobre bytes comprimidos) |
| Almacenamiento con Intelligent Tiering | USD 0,018 (sin acceso 30 días) y USD 0,006 (sin acceso 90 días) por GB-mes |
| Consultas sobre logs y trazas | USD 0,005 por GB escaneado, gratis hasta 5 veces tu ingesta mensual |
| Consultas PromQL | USD 0,01 por millón de muestras |
| Evaluaciones de agentes | a tarifas de Amazon Bedrock AgentCore Evaluations |
| Dashboards y alertas | incluidos (dentro de las cuotas del servicio) |
Para centralizar, la primera copia centralizada es gratis y cada copia adicional cuesta USD 0,05 por GB. Hay además una prueba gratuita de 30 días con USD 1.000 en créditos, solo para ingesta de telemetría OpenTelemetry, disponible para hasta 10 cuentas por AWS Organization (no todas las cuentas son elegibles; se chequea en la consola al activarlo).
Para dimensionar: en el ejemplo de AWS de un agente en producción con 1 TB de spans y 0,6 TB de logs por mes, el total estimado ronda los USD 657 más el costo de las evaluaciones. Como en todo CloudWatch, la ingesta de logs sigue siendo el componente que más pesa, así que la disciplina de qué logueás y con qué nivel sigue siendo la principal palanca de costo.
Filtrar antes de enviar
Si tu telemetría pasa por un OpenTelemetry Collector (contrib o ADOT), podés descartar lo que no aporta antes de que llegue a CloudWatch y no pagarlo nunca. Ojo: que Transaction Search indexe solo el 1% de los spans no achica la factura, porque la ingesta se cobra sobre todos.
processors:
  # Logs por debajo de INFO y health checks: afuera
  filter/logs:
    error_mode: ignore
    logs:
      log_record:
        - severity_number < SEVERITY_NUMBER_INFO
        - IsMatch(body, ".*GET /healthz.*")
  # Spans de health checks: afuera
  filter/traces:
    error_mode: ignore
    traces:
      span:
        - attributes["url.path"] == "/healthz"
  # Todos los errores y las lentas, y el 10% del resto
  tail_sampling:
    decision_wait: 10s
    policies:
      - name: errores
        type: status_code
        status_code: {status_codes: [ERROR]}
      - name: lentas
        type: latency
        latency: {threshold_ms: 1000}
      - name: resto
        type: probabilistic
        probabilistic: {sampling_percentage: 10}
tail_sampling necesita que todos los spans de una traza lleguen a la misma instancia del Collector (un gateway con loadbalancing exporter adelante). Y si usás el CloudWatch plugin en el SDK, las métricas RED se calculan antes del muestreo, así que no perdés precisión en las vistas de servicios.
Disponibilidad y lo que conviene mirar con lupa
Omni está disponible en us-east-1 (N. Virginia), us-west-2 (Oregón) y eu-west-1 (Irlanda). AWS aclara que esto no limita el uso: podés centralizar telemetría de todas tus cuentas y regiones en la región de Omni que prefieras.
Desde Latinoamérica, algunas cosas a tener en cuenta:
- No está en sa-east-1. Si tus cargas corren en São Paulo, vas a tener que centralizar en otra región. La primera copia centralizada no tiene cargo, pero la propia página de precios aclara que centralizar entre regiones puede generar los cargos estándar de transferencia de datos de AWS.
- Residencia de datos. Si trabajás en industrias reguladas o con requisitos de dónde pueden vivir los datos, revisá qué implica mover logs y trazas a Estados Unidos o Irlanda. Omni documenta cifrado con claves de KMS administradas por el cliente y guías para proteger datos sensibles en la telemetría.
- Acceso sin consola. Es una ventaja concreta en organizaciones donde los desarrolladores no tienen (ni deberían tener) acceso a la consola de producción: pueden investigar incidentes con SSO sin abrir permisos de IAM.
- Bearer tokens. Los endpoints de métricas y logs aceptan tokens de larga duración, pero la recomendación es usarlos solo cuando no hay forma de obtener credenciales temporales.
¿Vale la pena?
Depende mucho de dónde estás parado. Analistas consultados por InfoWorld coinciden en que las empresas con una plataforma madura en Datadog, New Relic o Grafana probablemente no tengan mucho para ganar migrando, y que los primeros en adoptarlo van a ser quienes ya usan CloudWatch y Bedrock AgentCore, porque su telemetría e instrumentación se trasladan tal cual. También puede servirles a organizaciones con varios pilotos de agentes que necesitan estandarizar cómo evalúan y operan.
Mi lectura: lo más interesante de Omni no es la interfaz nueva sino dos decisiones de fondo. Una es apostar de lleno a OpenTelemetry, lo que baja mucho el costo de probarlo (y de irte, si no te convence). La otra es tratar la calidad de las respuestas de un agente como una señal de observabilidad de primera clase, en la misma traza que la latencia y los tokens. Quienes estamos llevando agentes a producción sabemos que el “¿está respondiendo bien?” es la pregunta más difícil de contestar, y hasta ahora vivía en herramientas separadas.
Que AWS haya construido Omni sobre OpenTelemetry también dice mucho del lugar que ganó ese proyecto de la CNCF. Azure Monitor, Google Cloud Observability, Datadog, New Relic y Dynatrace ya reciben o generan telemetría OTel. Los proveedores dejaron de competir por cómo recolectás las señales y compiten por lo que hacen con ellas. Para vos eso significa que instrumentar con OTel hoy te deja libre de elegir (o cambiar) de backend mañana.
Si ya estás en CloudWatch, probarlo cuesta poco: activás Omni desde la consola, tu telemetría aparece sin reconfigurar nada y tenés USD 1.000 en créditos para experimentar. Y si estás construyendo agentes, la extensión para el IDE es gratis y ni siquiera necesita una cuenta de AWS.
Recursos
- Anuncio en What’s New
- Post en AWS News Blog: observabilidad de aplicaciones
- Post en AWS News Blog: observabilidad de agentes de IA
- Página del producto
- Precios de CloudWatch Omni
- Documentación de CloudWatch Omni
- Enviar telemetría de aplicaciones (EC2, ECS, EKS, Azure)
- Extensión de CloudWatch Omni para VS Code
- Demo interactiva
- Cobertura de InfoWorld