
Cualquiera que haya puesto un LLM en medio de un flujo automatizado conoce el ritual: le pedís JSON en el prompt, le das un ejemplo, le rogás que no agregue texto antes ni después, y aun así cada tanto aparece una coma de más, un campo con otro nombre o un "Claro, acá tenés el JSON:" que rompe el json.loads. Entonces sumás validación, reintentos y un parser tolerante, y el código que rodea al modelo termina siendo más grande que la lógica de negocio.
El 20 de octubre de 2026 AWS anunció que Amazon Bedrock soporta salidas estructuradas (structured outputs) para todos los modelos Claude de Anthropic, tanto en el endpoint bedrock-runtime como en bedrock-mantle. Definís un JSON Schema y la respuesta lo cumple, porque la restricción se aplica mientras el modelo genera los tokens, no después. Fue también la noticia principal del resumen semanal de Desplegando.cloud de esta semana, y con razón: es de esos cambios chicos en la API que te dejan borrar código.
En este artículo vemos qué cambió exactamente (porque Bedrock ya tenía structured outputs desde febrero), cómo funciona por dentro, qué límites tiene el schema, y armamos un caso real para DevOps: un servicio en Amazon EKS que recibe alertas de Alertmanager y las clasifica con Claude Haiku 5.5, devolviendo un JSON con el que se decide a quién despertar.
TL;DR
- Bedrock ahora ofrece structured outputs para todos los modelos Claude, en
bedrock-runtime(Converse, InvokeModel y Messages API) y enbedrock-mantle(Messages API). - Hay dos mecanismos: formato de salida JSON Schema (controla la forma de la respuesta) y strict tool use (
"strict": true, controla los parámetros con los que el modelo llama a una herramienta). Se pueden usar juntos. - Funciona con decodificación restringida: el modelo no puede emitir tokens que violen el schema. La primera vez que usás un schema se compila una gramática (puede tardar hasta ~90 segundos) y queda en caché 24 horas por cuenta.
- Límites concretos: todo objeto con
additionalProperties: false, máximo 12 propiedades opcionales y 16 propiedades con unión de tipos oanyOf; sinminimum/maximum, sinminLength/maxLength, sin schemas recursivos. - Es incompatible con citations en modelos de Anthropic (devuelve 400) y no todos los perfiles geográficos de inferencia lo soportan para todos los modelos.
- No hay un cargo aparte anunciado: pagás los tokens del modelo. Y como el modelo responde solo lo que pide el schema, suele gastar menos tokens de salida.
- Igual tenés que revisar
stop_reason: si corta pormax_tokens, el JSON queda incompleto.
Por qué ahora
Structured outputs no es nuevo en Bedrock. En febrero de 2026 AWS lo lanzó en disponibilidad general para modelos de varios proveedores (Anthropic, DeepSeek, Google, MiniMax, Mistral AI, Moonshot AI, NVIDIA, OpenAI y Qwen), con los ejemplos sobre Claude Opus 4.5. El problema era la cobertura: no todos los modelos de Claude lo tenían, y en particular la familia Claude 5 quedó afuera durante meses.
Eso se vio en el ecosistema. En el AI SDK de Vercel, por ejemplo, un issue de julio documentaba que Bedrock rechazaba strict en claude-sonnet-5 con un error 400, y el SDK terminó limitando las salidas estructuradas nativas a los modelos Claude 4.x. El 20 de octubre, apenas salió el anuncio, se abrió otro issue pidiendo habilitarlo para Claude 5. Si usás una librería por encima de Bedrock, ese detalle importa: que Bedrock lo soporte no significa que tu SDK ya lo mande.
El anuncio de octubre cierra esa brecha: todos los modelos Claude, los dos endpoints, y además inferencia en lotes (batch), inferencia entre regiones y streaming con eventos tipados. Para quien está llevando agentes y automatizaciones a producción, eso convierte structured outputs en algo que podés asumir como base, sin una tabla de "con qué modelo sí y con cuál no".
Qué es y qué no es
Structured outputs es una garantía sobre la forma de la respuesta. Si el schema dice que severity es uno de info, warning o critical, el modelo no puede devolver "Severity": "CRITICAL!". Si dice que un objeto no admite propiedades adicionales, no aparecen campos inventados.
Structured outputs no es:
- Una garantía sobre el contenido. El JSON va a ser válido, pero el modelo puede clasificar mal una alerta. La calidad se evalúa aparte.
- Validación de negocio. Como el schema no admite
minimumnimaximum, un camporeplicasde tipo entero puede venir con 500. Los rangos los seguís validando en tu código. - Una garantía absoluta de JSON completo. Si el modelo llega al límite de
max_tokenso se niega a responder, la salida puede no cumplir el schema. Por eso la documentación insiste en revisarstop_reasonen cada respuesta. - Lo mismo que pedir JSON en el prompt. Esa técnica sigue funcionando "casi siempre". Esto es otra cosa: la restricción está en el decodificador.
Cómo funciona por dentro
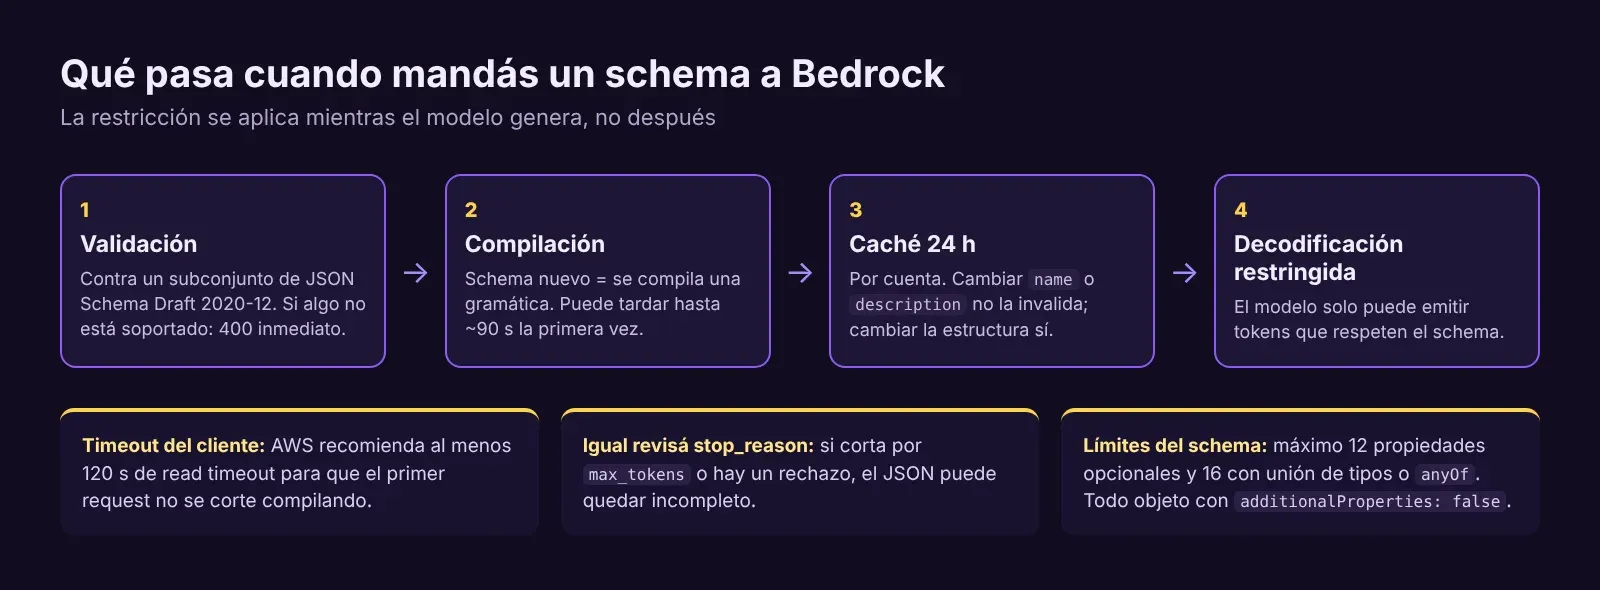
Cuando un request trae un schema, Bedrock:
- Lo valida contra un subconjunto de JSON Schema Draft 2020-12. Si usás algo no soportado, devuelve un 400 de inmediato.
- Compila una gramática si es la primera vez que ve ese schema. Este paso puede tardar hasta unos 90 segundos, y por eso AWS recomienda configurar el read timeout del cliente en al menos 120 segundos.
- Guarda la gramática en caché durante 24 horas, a nivel de cuenta y cifrada con claves administradas por AWS. Cambiar solo
nameodescriptionno invalida la caché; cambiar la estructura, sí. - Genera con decodificación restringida: en cada paso, el modelo solo puede elegir tokens que mantengan la salida dentro del schema.
El punto 2 tiene una consecuencia operativa que es fácil pasar por alto: el primer request con un schema nuevo es lento. Si desplegás una versión nueva de tu servicio con un schema modificado, el primer usuario (o la primera alerta) se come esa latencia. Más abajo vemos cómo resolverlo con un warm-up en el arranque del pod.
Dos mecanismos: formato de salida y strict tool use
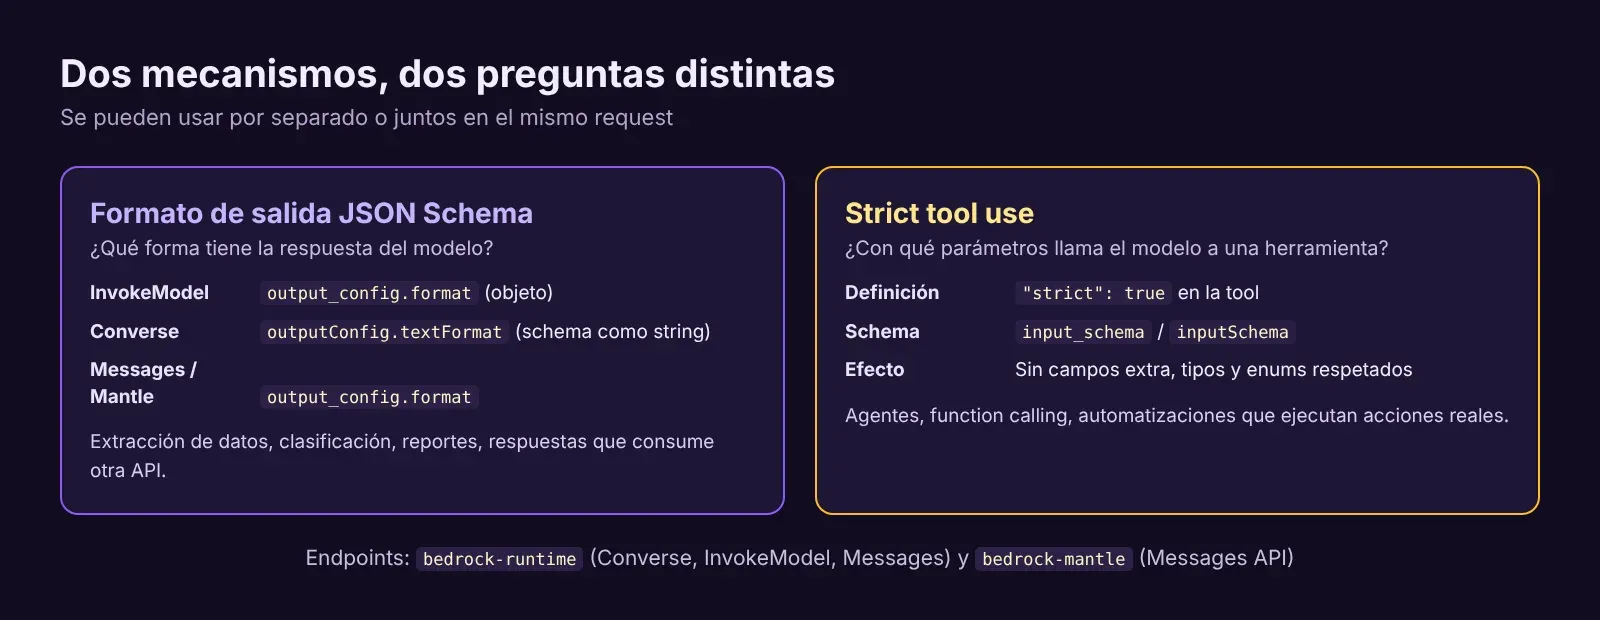
Formato de salida JSON Schema. Controla la respuesta del modelo. Es lo que querés para extracción de datos, clasificación, generación de reportes o cualquier respuesta que consume otro sistema. Dónde va el schema depende de la API:
| API | Campo | Cómo va el schema |
|---|---|---|
| InvokeModel (Claude) | output_config.format |
Objeto JSON, con type: "json_schema" y schema |
| Converse / ConverseStream | outputConfig.textFormat |
String JSON dentro de structure.jsonSchema.schema, con name y description |
Messages API (bedrock-runtime o bedrock-mantle) |
output_config.format |
Objeto JSON |
| InvokeModel (modelos open weight) | response_format |
Según el formato del proveedor |
Strict tool use. Controla los argumentos con los que el modelo llama a una herramienta. Agregás "strict": true a la definición de la tool y el input_schema se vuelve obligatorio en serio: tipos respetados, enums respetados, sin campos extra. Para agentes que ejecutan acciones reales (abrir un ticket, escalar un deployment, rotar un secreto), esto es lo que más tranquilidad da.
Qué admite el schema (y qué no)
Esta es la parte que más vas a consultar mientras diseñás schemas.
Soportado:
- Tipos básicos:
object,array,string,integer,number,boolean,null. enumcon strings, números, booleanos o nulls;const;anyOfyallOf(con limitaciones).$ref,$defydefinitions, solo referencias internas.- Formatos de string:
date-time,time,date,duration,email,hostname,uri,ipv4,ipv6,uuid. patterncon expresiones regulares (una regex inválida devuelveInvalid regex in pattern field.).minItemsen arrays, pero solo con 0 o 1.
No soportado:
- Schemas recursivos y
$refexternos. - Restricciones numéricas (
minimum,maximum,multipleOf). - Restricciones de longitud de string (
minLength,maxLength). additionalPropertiescon cualquier valor que no seafalse. De hecho, es obligatorio ponerlo en todos los objetos.
Límites de complejidad:
- Hasta 12 propiedades opcionales en total, contando todos los objetos anidados. Una propiedad es opcional si no está en
required. Si te pasás, el error esSchema is too complexy, como se detecta durante la compilación, puede tardar hasta ~90 segundos en llegar. - Hasta 16 propiedades que usen un array de tipos (por ejemplo
"type": ["string", "null"]) oanyOf. Este error sí es inmediato.
Incompatibilidades:
- Con citations en modelos de Anthropic: si las habilitás junto con structured outputs, la respuesta es un 400.
- Algunos perfiles geográficos de inferencia no soportan structured outputs para todos los modelos. La documentación da como ejemplo Claude Haiku 4.5 a través del perfil de India (
in.anthropic).
Manos a la obra
Vamos a construir un servicio de triage de alertas que corre en Amazon EKS. Alertmanager le manda un webhook cada vez que se dispara un grupo de alertas, el servicio le pasa el contexto a Claude Haiku 5.5 con un schema, y el JSON que vuelve decide si se pagina a la guardia, a qué equipo va y qué acción sugerir.
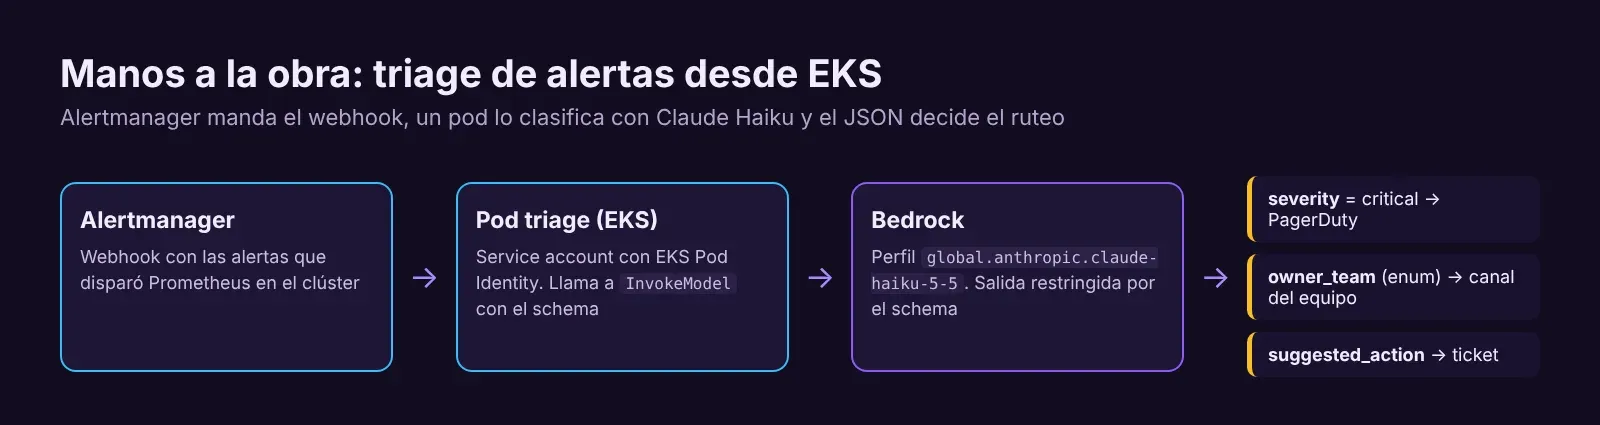
Elegimos Haiku 5.5 porque es el modelo que AWS recomienda para cargas rápidas y repetitivas como la clasificación, y porque el costo por alerta es mínimo. Usamos el perfil de inferencia global (global.anthropic.claude-haiku-5-5), que además es la única forma de usar Haiku 5.5 desde sa-east-1.
1. Permisos con EKS Pod Identity
El pod necesita poder invocar el modelo. Con EKS Pod Identity (el agente tiene que estar instalado como add-on en el clúster), creás un rol con esta confianza:
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": { "Service": "pods.eks.amazonaws.com" },
    "Action": ["sts:AssumeRole", "sts:TagSession"]
  }]
}
Y una política acotada al perfil de inferencia global y al modelo de fondo:
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Action": ["bedrock:InvokeModel"],
    "Resource": [
      "arn:aws:bedrock:*:123456789012:inference-profile/global.anthropic.claude-haiku-5-5*",
      "arn:aws:bedrock:*::foundation-model/anthropic.claude-haiku-5-5*"
    ]
  }]
}
Después asociás el rol a la service account del servicio:
aws eks create-pod-identity-association \
  --cluster-name produccion \
  --namespace observability \
  --service-account alert-triage \
  --role-arn arn:aws:iam::123456789012:role/alert-triage-bedrock
2. El schema
Todo va en required para no gastar el cupo de 12 opcionales, y donde un valor puede no existir usamos ["string", "null"] (eso cuenta para el límite de 16 uniones, no para el de opcionales):
TRIAGE_SCHEMA = {
    "type": "object",
    "properties": {
        "severity": {"type": "string", "enum": ["info", "warning", "critical"],
                     "description": "Impacto real para usuarios, no la severidad que trae la alerta"},
        "owner_team": {"type": "string", "enum": ["platform", "payments", "data", "frontend", "unknown"],
                       "description": "Equipo dueño según namespace, servicio y labels"},
        "page_oncall": {"type": "boolean", "description": "Si hay que despertar a la guardia ahora"},
        "probable_cause": {"type": "string", "description": "Causa probable en una oración"},
        "suggested_action": {"type": "string", "description": "Primer paso concreto a seguir"},
        "runbook_url": {"type": ["string", "null"], "format": "uri",
                        "description": "URL del runbook si aparece en las anotaciones; null si no"},
        "related_alerts": {"type": "array", "items": {"type": "string"},
                           "description": "Nombres de otras alertas del grupo con la misma causa"}
    },
    "required": ["severity", "owner_team", "page_oncall", "probable_cause",
                 "suggested_action", "runbook_url", "related_alerts"],
    "additionalProperties": False
}
El enum de owner_team es lo que hace que este JSON sirva para rutear: no hay forma de que el modelo invente un equipo que no existe en tu tabla de canales.
3. El servicio de triage
Un servidor HTTP mínimo, sin dependencias además de boto3, que recibe el webhook de Alertmanager:
import json, os
from http.server import BaseHTTPRequestHandler, HTTPServer
import boto3
from botocore.config import Config

MODEL_ID = os.environ.get("MODEL_ID", "global.anthropic.claude-haiku-5-5")
bedrock = boto3.client(
    "bedrock-runtime",
    region_name=os.environ.get("AWS_REGION", "sa-east-1"),
    # La primera llamada con un schema nuevo compila la gramática: hasta ~90 s
    config=Config(read_timeout=120, retries={"max_attempts": 3, "mode": "adaptive"}),
)

SYSTEM = ("Sos un ingeniero SRE que hace triage de alertas de Kubernetes. "
          "Respondé solo con lo que pide el schema. Si no hay evidencia suficiente, "
          "usá owner_team='unknown' y page_oncall=false.")

def triage(payload: dict) -> dict:
    alerts = [{"status": a.get("status"), "labels": a.get("labels", {}),
               "annotations": a.get("annotations", {})} for a in payload.get("alerts", [])]
    resp = bedrock.invoke_model(
        modelId=MODEL_ID,
        body=json.dumps({
            "anthropic_version": "bedrock-2023-05-31",
            "max_tokens": 1024,
            "system": SYSTEM,
            "messages": [{"role": "user", "content":
                          "Grupo de alertas de Alertmanager:\n" + json.dumps(alerts, ensure_ascii=False)}],
            "output_config": {"format": {"type": "json_schema", "schema": TRIAGE_SCHEMA}},
        }),
    )
    body = json.loads(resp["body"].read())
    if body["stop_reason"] != "end_turn":
        # max_tokens, rechazo u otro corte: el JSON puede no cumplir el schema
        raise RuntimeError(f"respuesta incompleta: stop_reason={body['stop_reason']}")
    text = next(b["text"] for b in body["content"] if b["type"] == "text")
    return json.loads(text)

class Handler(BaseHTTPRequestHandler):
    def do_POST(self):
        payload = json.loads(self.rfile.read(int(self.headers["Content-Length"])))
        try:
            result = triage(payload)
            route(result)
            self.send_response(200)
        except Exception as exc:
            print(f"triage fallido, se rutea por default: {exc}")
            self.send_response(500)
        self.end_headers()

    def do_GET(self):  # readiness
        self.send_response(200 if READY else 503)
        self.end_headers()

def route(r: dict) -> None:
    # Acá iría la integración real con PagerDuty, Slack o tu sistema de tickets
    print(json.dumps({"route": "page" if r["page_oncall"] else r["owner_team"], **r}, ensure_ascii=False))

READY = False
if __name__ == "__main__":
    # Warm-up: compila la gramática antes de recibir tráfico real
    triage({"alerts": [{"status": "firing", "labels": {"alertname": "Warmup", "namespace": "default"},
                        "annotations": {"summary": "alerta de prueba para compilar el schema"}}]})
    READY = True
    HTTPServer(("0.0.0.0", 8080), Handler).serve_forever()
Fijate en dos detalles. El primero es que no hay validación con jsonschema ni reintentos por JSON mal formado: no hacen falta. El segundo es el warm-up: el pod hace una llamada de prueba al arrancar y recién después responde 200 en el endpoint de readiness. Así la compilación de la gramática ocurre durante el rollout y no con la primera alerta real de la madrugada.
4. El Deployment y la configuración de Alertmanager
apiVersion: v1
kind: ServiceAccount
metadata:
  name: alert-triage
  namespace: observability
---
apiVersion: apps/v1
kind: Deployment
metadata:
  name: alert-triage
  namespace: observability
spec:
  replicas: 2
  selector:
    matchLabels: { app: alert-triage }
  template:
    metadata:
      labels: { app: alert-triage }
    spec:
      serviceAccountName: alert-triage
      containers:
        - name: triage
          image: 123456789012.dkr.ecr.sa-east-1.amazonaws.com/alert-triage:1.0.0
          ports:
            - containerPort: 8080
          env:
            - name: MODEL_ID
              value: global.anthropic.claude-haiku-5-5
          readinessProbe:
            httpGet: { path: /ready, port: 8080 }
            periodSeconds: 5
            failureThreshold: 30
---
apiVersion: v1
kind: Service
metadata:
  name: alert-triage
  namespace: observability
spec:
  selector: { app: alert-triage }
  ports:
    - port: 8080
      targetPort: 8080
El failureThreshold: 30 con periodSeconds: 5 le da al pod hasta 150 segundos para terminar el warm-up antes de que Kubernetes lo considere no listo.
En Alertmanager, el receiver apunta al Service:
receivers:
  - name: ai-triage
    webhook_configs:
      - url: http://alert-triage.observability.svc:8080/alerts
        send_resolved: false
Conviene que este receiver vaya en paralelo a tu ruteo actual (con continue: true en la ruta) durante las primeras semanas. Así comparás lo que decidió el modelo contra lo que hizo la guardia sin arriesgar una alerta crítica perdida.
5. La misma llamada con la Converse API
Si tu código ya usa Converse (por ejemplo, para poder cambiar de modelo sin tocar el formato del body), el schema va como string en outputConfig.textFormat:
resp = bedrock.converse(
    modelId="global.anthropic.claude-haiku-5-5",
    system=[{"text": SYSTEM}],
    messages=[{"role": "user", "content": [{"text": "Grupo de alertas:\n" + json.dumps(alerts)}]}],
    inferenceConfig={"maxTokens": 1024},
    outputConfig={
        "textFormat": {
            "type": "json_schema",
            "structure": {
                "jsonSchema": {
                    "schema": json.dumps(TRIAGE_SCHEMA),
                    "name": "alert_triage",
                    "description": "Clasificación de un grupo de alertas de Kubernetes",
                }
            },
        }
    },
)
if resp["stopReason"] == "end_turn":
    result = json.loads(resp["output"]["message"]["content"][0]["text"])
6. Strict tool use para un agente que actúa
Ahora supongamos que querés ir un paso más allá y que un agente pueda proponer un escalado. Con strict: true, los argumentos de la tool siempre cumplen el schema. Este ejemplo usa el cliente de bedrock-mantle del SDK de Anthropic, como en la documentación:
from anthropic import AnthropicBedrockMantle

client = AnthropicBedrockMantle(aws_region="us-east-1")

message = client.messages.create(
    model="anthropic.claude-sonnet-5",
    max_tokens=1024,
    messages=[{"role": "user", "content": "El deployment checkout en payments tiene la CPU al 95% hace 20 minutos."}],
    tools=[{
        "name": "scale_deployment",
        "description": "Propone escalar un Deployment de Kubernetes. Requiere aprobación humana.",
        "strict": True,
        "input_schema": {
            "type": "object",
            "properties": {
                "namespace": {"type": "string", "enum": ["payments", "frontend", "data"]},
                "deployment": {"type": "string", "pattern": "^[a-z0-9-]+$"},
                "replicas": {"type": "integer", "description": "Cantidad total de réplicas deseada"},
                "reason": {"type": "string"}
            },
            "required": ["namespace", "deployment", "replicas", "reason"],
            "additionalProperties": False
        }
    }]
)

for block in message.content:
    if block.type == "tool_use":
        args = block.input
        # El schema no admite minimum/maximum: los límites se validan acá
        if not 1 <= args["replicas"] <= 20:
            raise ValueError(f"replicas fuera de rango: {args['replicas']}")
        print("Propuesta para aprobar:", args)
El enum de namespace y el pattern de deployment limitan bastante lo que el agente puede pedir. Lo que el schema no puede expresar (el rango de réplicas) va en código, y la ejecución real queda detrás de una aprobación humana.
Trampas comunes
- Read timeout corto. Con el default de muchos clientes HTTP, el primer request con un schema nuevo se corta durante la compilación. Usá 120 segundos o más.
- No revisar
stop_reason. Unmax_tokensbajo produce JSON truncado aunque structured outputs esté activo. - Schemas demasiado opcionales. Pasarte de 12 propiedades opcionales da
Schema is too complexdespués de hasta ~90 segundos. Poné todo enrequiredy usánullcomo valor posible. - Olvidar
additionalProperties: falseen un objeto anidado. Es un 400 inmediato. - Citations activadas. Son incompatibles con structured outputs en Claude.
- Cambiar el schema en cada deploy. Cada cambio estructural invalida la caché y vuelve a pagar la compilación. Versioná el schema como cualquier contrato de API.
- Confiar en el SDK sin mirar. Algunas librerías filtran
stricto no mandanoutput_configpara modelos que no tienen en su lista. Revisá el request que realmente sale.
Precios
AWS no anunció un cargo aparte por structured outputs: pagás los tokens de entrada y salida del modelo que uses, como en cualquier invocación. Lo que sí cambia es el consumo: como el modelo responde solo los campos del schema, sin preámbulos ni explicaciones, la salida suele ser más corta.
Como referencia, estos son los precios de lista que publica Anthropic por millón de tokens. Verificá la tabla de Bedrock para tu región y tipo de perfil antes de presupuestar:
| Modelo | Entrada (USD/MTok) | Salida (USD/MTok) | Uso típico con structured outputs |
|---|---|---|---|
| Claude Haiku 5.5 (prompts de hasta 100.000 tokens) | 0,10 | 0,50 | Clasificación, triage, extracción simple |
| Claude Sonnet 5.5 | 2 | 10 | Extracción de documentos complejos, agentes |
| Claude Opus 5.5 | 4 | 20 | Razonamiento pesado sobre el resultado |
Un ejemplo para dimensionar (cálculo propio con esos precios de lista): 100.000 grupos de alertas por mes, con unos 1.500 tokens de entrada y 150 de salida cada uno, en Haiku 5.5:
- Entrada: 150 millones de tokens × USD 0,10 = USD 15.
- Salida: 15 millones de tokens × USD 0,50 = USD 7,50.
- Total: unos USD 22,50 por mes.
Cómo bajar costos en la práctica:
- Batch inference para lo que no es urgente (reclasificar el histórico, extraer datos de documentos): Bedrock lo ofrece para modelos de Anthropic a un 50% menos que on-demand, y structured outputs funciona en batch.
- Prompt caching para el system prompt y las instrucciones fijas. Desde el 7 de octubre de 2026, la lectura de caché de Claude Sonnet 5.5 en Bedrock cuesta la mitad que antes.
- Elegí el modelo por tarea. Con la forma garantizada por el schema, muchas tareas que antes mandabas a Sonnet "para que no se equivoque en el formato" pueden bajar a Haiku.
- Descripciones cortas en el schema. El schema también es entrada; descripciones claras y breves ayudan al modelo y no inflan el prompt.
Disponibilidad y lo que conviene mirar con lupa
Structured outputs está disponible en todas las regiones donde se ofrecen los modelos Claude en Bedrock. La pregunta real desde Latinoamérica es qué modelos podés usar desde São Paulo y por qué camino.
- sa-east-1. Según la tabla de compatibilidad regional de Bedrock, Claude Haiku 5.5 en São Paulo está disponible solo a través de inferencia global entre regiones (
global.anthropic.*); no hay soporte en la región ni un perfil geográfico que incluya Brasil. Revisá la tabla para el modelo puntual que vayas a usar. - Residencia de datos. Un perfil global puede procesar el request en otra región. Para alertas de infraestructura suele no ser un problema; para documentos con datos personales, financieros o de salud, revisá qué te exige tu regulación antes de usar un perfil global. En el caso de las alertas, también conviene no mandar secretos ni datos de clientes que puedan venir en las anotaciones.
- Perfiles geográficos. No todos soportan structured outputs para todos los modelos. Si tu política obliga a usar un perfil geográfico, probá el schema con ese perfil exacto.
- Caché de gramáticas. Las gramáticas compiladas se guardan 24 horas, a nivel de cuenta y cifradas con claves administradas por AWS. Si tu equipo de seguridad pregunta qué se persiste, la respuesta es el schema compilado, no tus datos.
- Latencia. Desde São Paulo, la latencia de red hacia la región que termine atendiendo el request se suma a la del modelo. Para triage de alertas da lo mismo; para un endpoint síncrono de cara al usuario, medilo.
¿Vale la pena?
Si ya estás usando Claude en Bedrock para cualquier cosa que termine en un json.loads, sí, y el costo de adoptarlo es bajo: agregás output_config o outputConfig, ajustás el schema a las reglas (additionalProperties: false, todo en required) y borrás la capa de validación y reintentos. Para agentes con herramientas que tocan sistemas reales, strict: true debería ser el default desde hoy.
Donde conviene ir con cuidado es en schemas grandes y muy opcionales, como los que salen de convertir automáticamente un modelo de datos existente. Los límites de 12 opcionales y 16 uniones obligan a diseñar el schema pensando en el modelo, no en la base de datos.
Mi lectura: lo valioso de este anuncio no es la función en sí (existía desde febrero) sino que deja de depender del modelo. Mientras structured outputs funcionaba con algunos modelos de Claude y con otros no, cada cambio de modelo era un riesgo de romper el parsing, y las librerías tenían que mantener listas de modelos permitidos. Con cobertura completa, cambiar de Haiku a Sonnet o actualizar de versión vuelve a ser una decisión de calidad y costo, no de compatibilidad. Y para quienes hacemos plataforma, el patrón del ejemplo se generaliza: un modelo chico con un schema estricto, enums que mapean a decisiones reales y un humano aprobando lo que tiene impacto. Es la forma más aburrida y más segura de meter IA en un flujo de operaciones, y eso es un elogio.
Mi sugerencia para empezar: tomá un flujo donde hoy ya parseás JSON del modelo, migralo a structured outputs con el warm-up en el arranque, corré las dos versiones en paralelo una semana y compará tasa de errores de parsing (que debería ir a cero) y tokens de salida.
Recursos
- Anuncio en What's New: structured outputs para modelos Claude
- Post en el blog de Machine Learning de AWS: Structured outputs for Anthropic Claude models on Amazon Bedrock
- Post de febrero: Structured outputs on Amazon Bedrock
- Documentación: structured outputs para Claude (Messages API)
- Documentación: Get validated JSON results from models
- Compatibilidad regional de modelos de Anthropic
- Precios de Amazon Bedrock
- Issue en el AI SDK de Vercel sobre soporte para Claude 5
- Desplegando.cloud, noticias de la semana del 26/10/26