
Cuando armás un agente de IA, una parte enorme de las llamadas al LLM no son para generar texto sino para decidir algo chiquito: ¿a qué equipo va este ticket?, ¿este argumento de la herramienta lo dijo el usuario o lo inventó el modelo?, ¿este mensaje es urgente?, ¿uso el modelo caro o el barato? Para cada una de esas preguntas mandamos el contexto entero a un modelo frontera, esperamos uno o dos segundos y parseamos una respuesta en texto libre que, encima, no trae ninguna medida de qué tan seguro está.
Strands Labs, el espacio experimental del equipo de Strands Agents en AWS, publicó Strands Decider 2B, un modelo open source (Apache 2.0) diseñado exactamente para ese hueco. No genera texto: recibe un estado y una lista de preguntas, y para cada una elige entre opciones cerradas y devuelve una probabilidad calibrada. Corre local, en una GPU de escritorio contesta en unos 115 ms de mediana, y se integra con el sistema de intervenciones de Strands Agents para revisar cada tool call antes de que se ejecute. Fue la noticia que le dio título al resumen de esta semana de Desplegando.cloud, y vale la pena mirarla con detalle porque propone una forma distinta de diseñar agentes.
TL;DR
- Es un modelo de decisión (los autores lo llaman modelo "system one"): elige entre opciones, contesta sí/no o puntúa en una escala, siempre con una probabilidad. No escribe texto.
- Arquitectura: el tronco de Qwen3.5-2B-Base sin su cabeza de lenguaje, con una cabeza de puntero de alrededor de un millón de parámetros y adaptadores LoRA de rango 16. Una sola pasada hacia adelante, sin bucle de generación.
- Latencia de la primera versión: 115 ms de mediana (299 ms en p95) en una RTX 3090; 153 ms en una MacBook M3 Pro.
- En JevBench (231 tareas públicas), la versión de referencia actual acierta 180 (0,779). Las variantes sobre Gemma 4 llegan a 207 con el modelo de 26B.
- Se instala con
pip install strands-decidery se usa por CLI o como servidor HTTP local (/v1/systemone). - Se engancha en Strands Agents con un
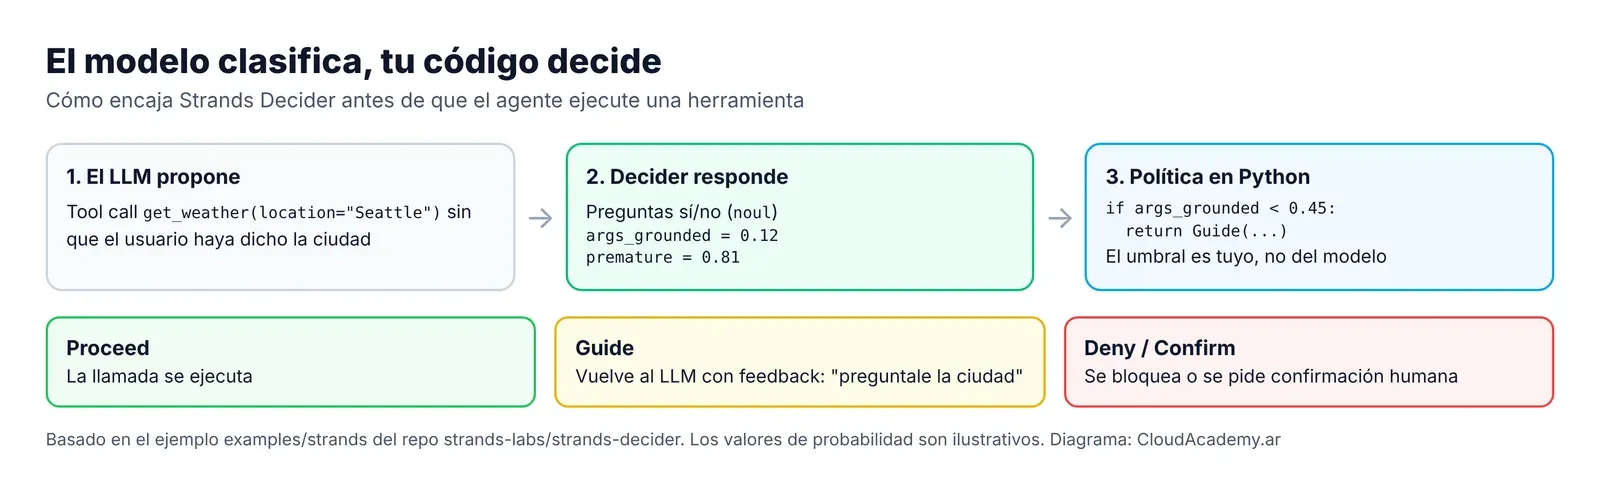
InterventionHandler: el decider clasifica y tu código decide si la tool call sigue (Proceed) o vuelve al LLM con feedback (Guide). - Es un experimento, no un servicio administrado de AWS: lo corrés vos, en tu infraestructura.
Por qué ahora
El concepto de "modelo de decisión" tomó visibilidad en septiembre, cuando TypeSafe AI salió de modo stealth con Jev, un modelo propietario que devuelve decisiones tipadas (elecciones, puntajes, sí/no) en lugar de texto, con acceso por lista de espera y un precio publicado de USD 0,042 por millón de tokens de entrada. El propio post de Strands reconoce que Jev puso el tema sobre la mesa, y evalúa su modelo contra JevBench, el benchmark asociado a ese enfoque. La diferencia es de modelo de distribución: Jev es un servicio cerrado; Strands Decider viene con pesos, código y hasta las recetas de entrenamiento.
El contexto más amplio es que los agentes en producción se están volviendo caros y lentos por acumulación. Un agente que hace cinco tool calls y, para cada una, una verificación con un LLM de propósito general, termina multiplicando la latencia y los tokens. Y esas verificaciones tienen un problema adicional: un modelo conversacional al que le preguntás "¿tus argumentos están bien fundamentados?" puede ser convencido de que sí. Un clasificador que devuelve un número sobre el que tu código hace un if no negocia.
Qué es y qué no es
Strands Decider responde tres tipos de preguntas sobre un estado (un texto, una conversación, opcionalmente una imagen):
| Tipo | Qué devuelve | Ejemplo |
|---|---|---|
noul (sí/no) | Probabilidad de "sí", entre 0 y 1 | ¿Este mensaje transmite urgencia? |
choice | Una opción de N, con la probabilidad de cada una | ¿Qué equipo atiende esto? billing, sales, retail |
score | Un nivel en una escala ordenada | ¿Qué tan frustrado está? calm, frustrated, depressed |
Lo que sí es:
- Un clasificador general que no necesita reentrenarse para cada tarea: las opciones y sus descripciones viajan en la request.
- Un modelo que siempre devuelve una de las opciones que le diste. No hay que parsear ni validar salidas.
- Calibrado: en tareas cortas de clasificación que no vio en el entrenamiento, las respuestas con confianza de 0,9 o más aciertan alrededor del 95% de las veces, según el README.
- Eficiente para hacer muchas preguntas sobre el mismo estado: el estado se codifica una vez y se comparte.
Lo que no es:
- No es un LLM. No sirve para chatear, resumir ni escribir código.
- No reemplaza a un modelo de razonamiento en problemas complejos. Los autores son explícitos en que es más débil ahí.
- No es un servicio de AWS ni está en Amazon Bedrock. Es un proyecto de Strands Labs que corrés vos.
- No es una política de seguridad. Te da probabilidades; los umbrales y la acción los decide tu código.
Cómo funciona por dentro
La idea técnica es elegante. Un LLM decodificador tiene un tronco (las capas de transformer) y una cabeza de lenguaje que convierte el último estado oculto en probabilidades sobre todo el vocabulario. Strands Decider se queda con el tronco de Qwen3.5-2B-Base, descarta la cabeza de lenguaje y pone en su lugar una cabeza de puntero.
La entrada se arma con un formato fijo: el estado, la pregunta, las opciones numeradas y una marca <answer>. La cabeza de puntero toma el estado oculto al final de cada opción y lo compara con el estado oculto en la posición de <answer> (un producto escalar tipo atención). Eso da un logit por opción, un softmax los convierte en probabilidades, y listo: una pasada hacia adelante, sin generar ni un token.
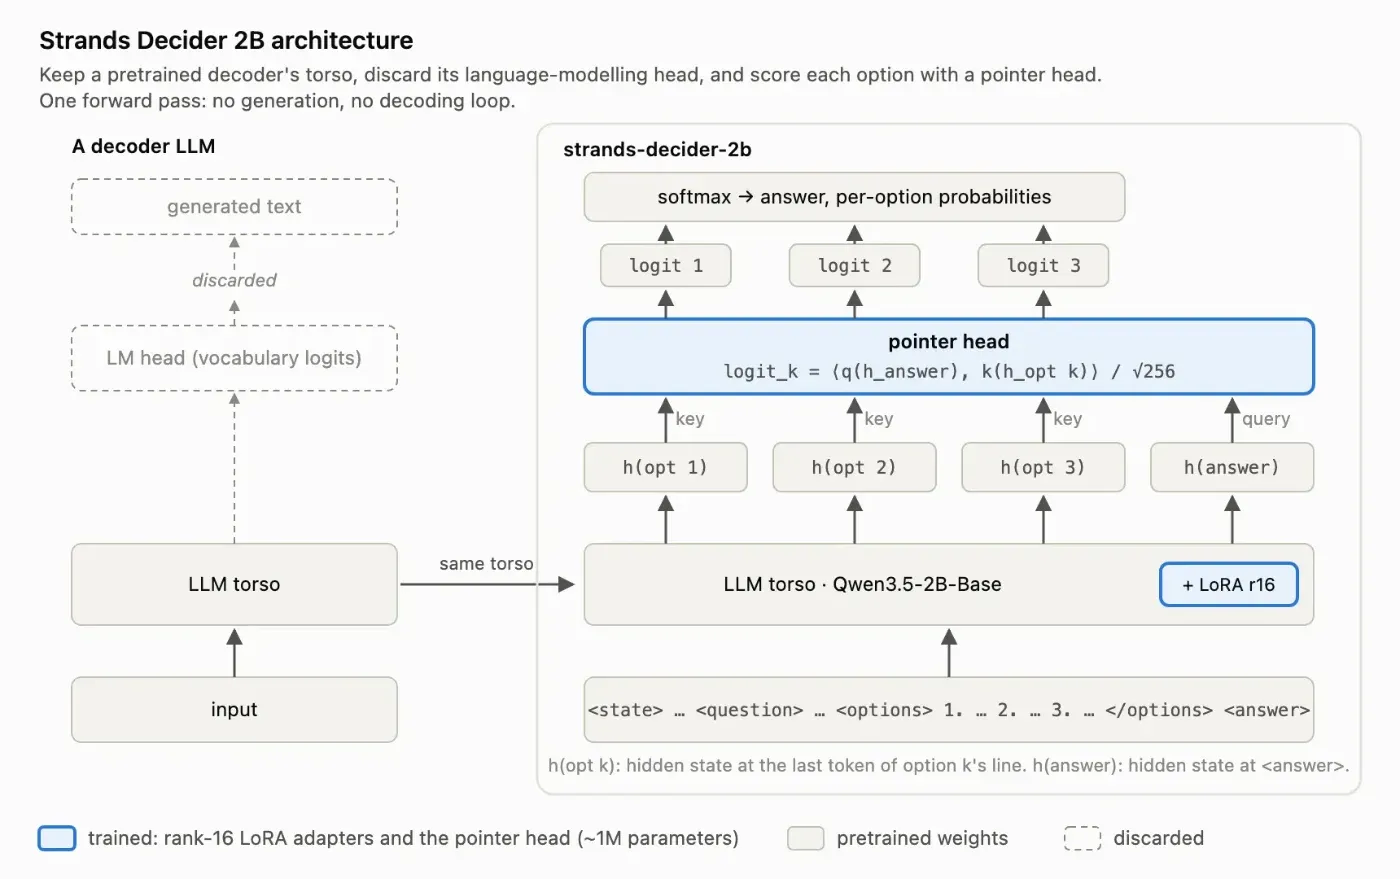
Dos consecuencias de este diseño que importan en la práctica:
- La cabeza no tiene parámetros por opción. El modelo no puede aprender que "la primera opción suele ser la correcta", y podés cambiar los nombres de las opciones sin reentrenar nada.
- Lo que se entrena es poco. Solo los adaptadores LoRA y la cabeza. Por eso el repositorio puede publicar la receta completa: unas 11 horas en una RTX 3090, o alrededor de 1 hora y 10 minutos en ocho H100.
Según el README, el entrenamiento usa filas de 25 datasets públicos de Hugging Face (cinco de ellos de código), y la versión actual se entrenó usando a un modelo más grande como "maestro" en los casos donde su respuesta coincide con la etiqueta correcta.
Las versiones disponibles
El proyecto se movió rápido desde el anuncio del 1 de octubre. El modelo original fue strands-decider-2B-hobson-v19; hoy la referencia es strands-decider-2B-qwen3.5-v1-2610 (el sufijo es año y mes de publicación), y en main aparecieron variantes sobre Gemma 4. Los cinco modelos v1 también están publicados en la organización amazon de Hugging Face.
| Modelo | JevBench (de 231) | Brier (menor es mejor) | Memoria de pesos (bf16) |
|---|---|---|---|
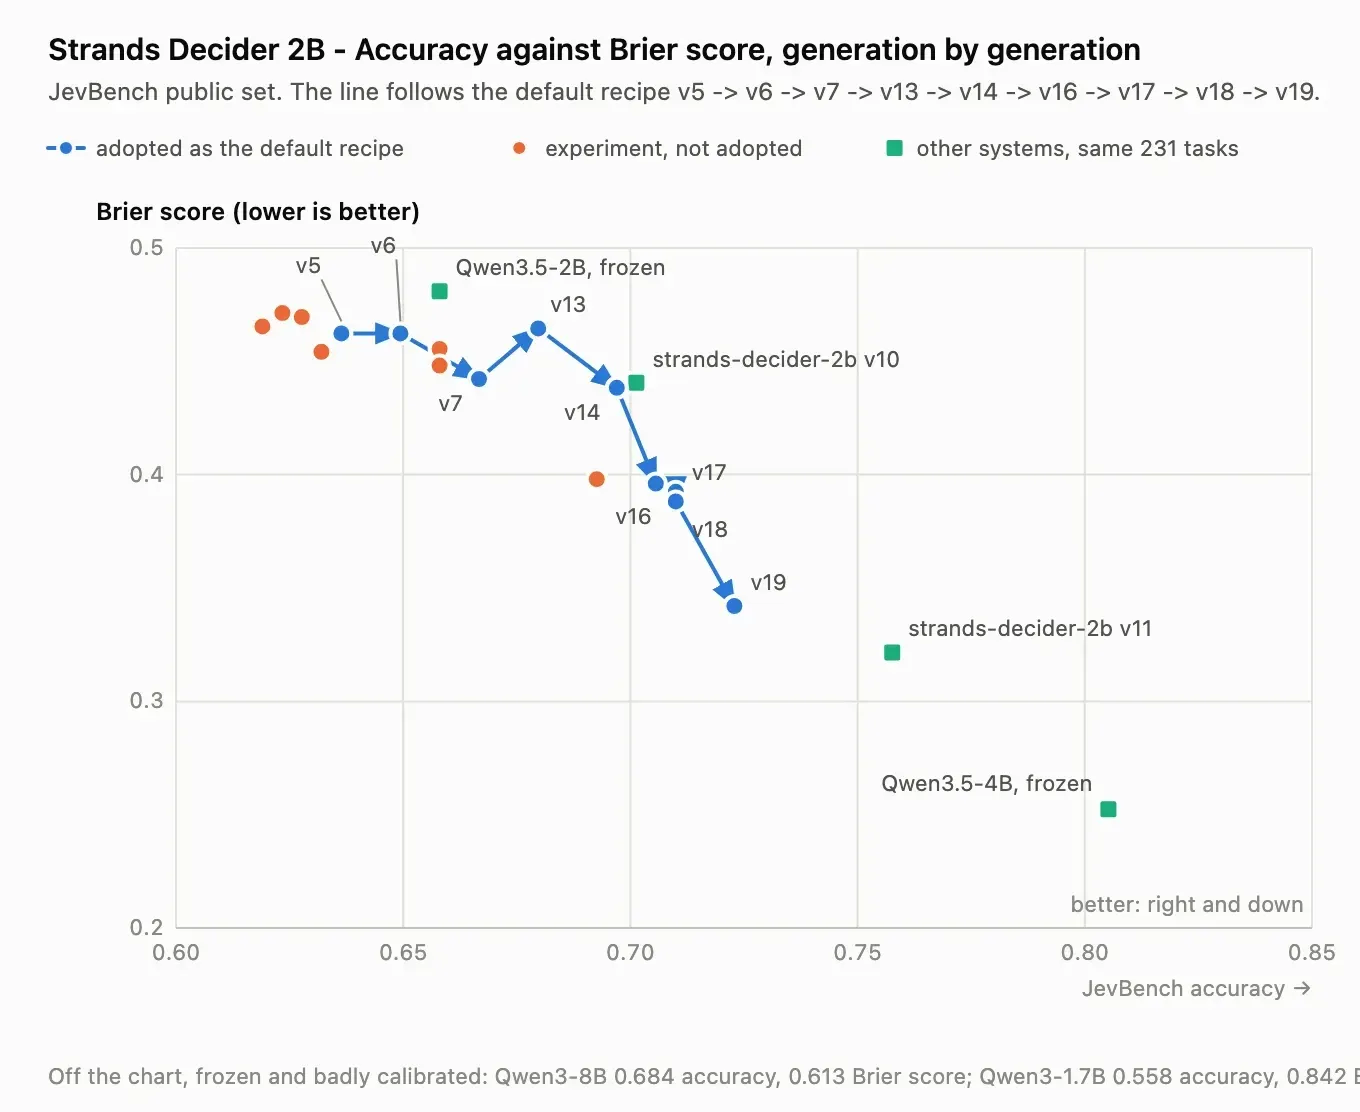
| 2B hobson-v19 (anuncio) | 167 (0,723) | 0,342 | — |
| 2B hobson-v21 | 176 (0,762) | 0,323 | — |
| 2B qwen3.5-v1-2610 (referencia) | 180 (0,779) | 0,280 | — |
| E2B gemma4-v1-2610 | 180 | 0,313 | ≈ 9 GB |
| E4B gemma4-v1-2610 | 187 | 0,243 | ≈ 15 GB |
| 12B gemma4-v1-2610 | 200 | 0,173 | ≈ 23 GB |
| 26B-A4B gemma4-v1-2610 | 207 | 0,162 | ≈ 51 GB |
El propio README advierte que con 231 tareas, una diferencia de menos de unas 10 entre dos corridas no es confiable. Para la v19, la cobertura de Techstrong.ai detalla 100% de acierto en las tareas fáciles y 50,5% en las difíciles: es muy bueno en lo rutinario y mediocre en lo complejo, que es justamente lo que promete.
Latencia
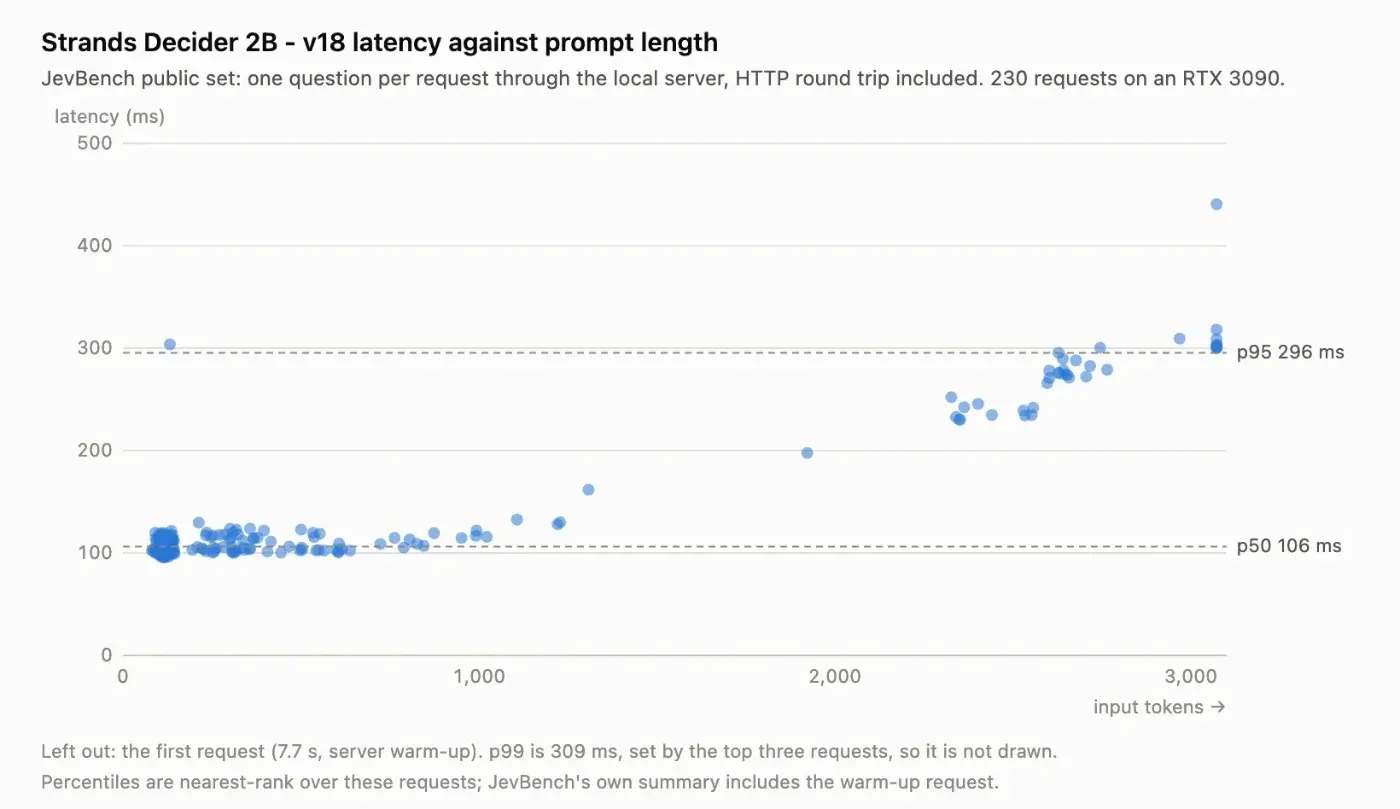
Con la v19 en una RTX 3090, la mediana por pregunta fue de 115 ms y el p95 de 299 ms; en una M3 Pro, 153 ms de mediana en caliente para tareas de menos de 300 tokens. La latencia crece de forma aproximadamente lineal con el tamaño del estado, y la primera request paga un calentamiento de varios segundos. En Apple Silicon, el backend MLX es entre 1,4 y 1,6 veces más rápido que MPS.
Dónde pega en un agente
Los autores mencionan ruteo de modelos, selección de herramientas, evaluaciones, guardarraíles, memoria, manejo de contexto y clasificación de políticas. Bajado a tierra, lo veo en cuatro lugares concretos:
- Revisar tool calls antes de ejecutarlas. ¿Los argumentos salen de lo que dijo el usuario? ¿Falta aclarar algo? ¿Es una acción destructiva?
- Ruteo de modelos. Decidir si una consulta la contesta un modelo chico o hay que escalar al grande, sin gastar un modelo grande para tomar esa decisión.
- Triage. Clasificar tickets, alertas o correos por equipo, urgencia y tono en una sola request.
- Evaluaciones en línea. Puntuar respuestas del agente con una rúbrica fija sobre tráfico real, mucho más barato que usar un LLM como juez para todo.
La arquitectura que proponen es híbrida: el LLM se queda con las decisiones difíciles y la conversación, y el decider resuelve las rutinarias. Y como cada respuesta trae probabilidad, podés usar el decider como primer filtro y mandar al LLM solo los casos donde la confianza es baja.
Manos a la obra
1. Instalar y preguntar desde la CLI
Necesitás Python 3.10 o superior. El paquete trae PyTorch y Transformers como dependencias, así que conviene un entorno virtual.
python -m venv .venv && source .venv/bin/activate
pip install strands-decider

strands-decider ask StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 \
  --state "Help! My payouts have been failing for 3 days! " \
  --choice "Which team should handle this?=billing,sales,retail" \
  --noul "Does this convey urgency?" \
  --score "How frustrated is the writer?=calm,frustrated,depressed"
La salida de ejemplo del README (corrida en CPU) se ve así:
noul_0 noul = 0.858
choice_0 -> billing (confidence 0.659)
  billing                  0.773
  sales                    0.121
  retail                   0.106
score_0 score = 1.03 (confidence 0.509)
  0: calm                                     0.196
  1: frustrated                               0.574
  2: depressed                                0.230
Fijate en el score: 1,03 con confianza 0,509. El modelo te está diciendo que está entre "frustrado" y las otras dos opciones, y que no está muy seguro. Esa información es la que un LLM no te da.
2. Levantarlo como servidor
strands-decider serve StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 --port 8000

curl -s localhost:8000/v1/systemone \
  -H 'content-type: application/json' \
  -d '{
    "state": "Help! My payouts have been failing for 3 days!",
    "questions": {
      "is_urgent": {"type": "noul", "instructions": "Does this convey urgency?"},
      "team": {"type": "choice", "instructions": "Which team should handle this?",
               "criteria": {"billing": "payments and payouts", "sales": "new deals", "retail": "store issues"}}
    }
  }'
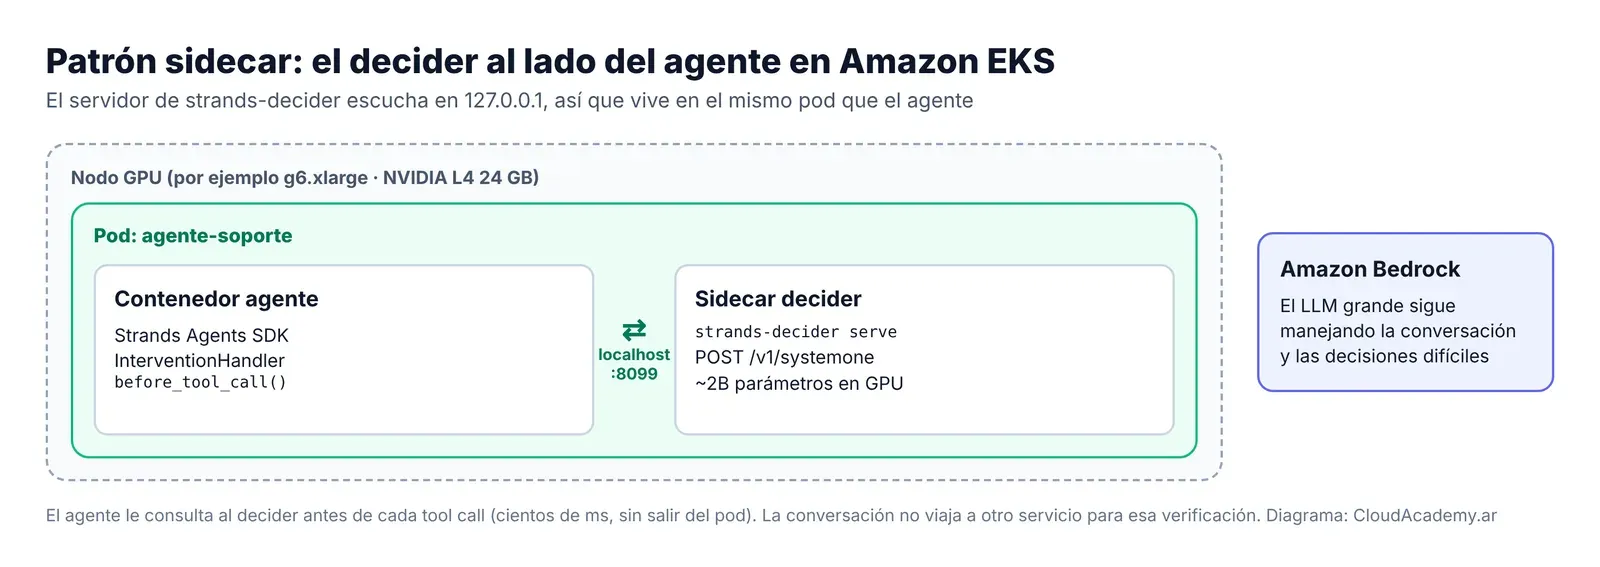
La respuesta trae answers con una clave por pregunta, más usage (tokens de entrada) y latency_ms. También hay un /health que informa el checkpoint, el modelo base, el dispositivo y la ventana de contexto. Dos cosas a tener en cuenta: el servidor escucha en 127.0.0.1 y no tiene autenticación. No lo expongas detrás de un Service público.
3. Revisar tool calls en un agente de Strands
Este es el ejemplo del repositorio (examples/strands/), recortado para que se vea la idea. El agente tiene una herramienta get_weather y un system prompt "ansioso" que lo empuja a inventar la ciudad si el usuario no la dice. El decider revisa la llamada antes de que se ejecute:
import json
from strands import Agent, tool
from strands.interventions import Guide, InterventionHandler, Proceed
from _client import Decider  # cliente HTTP mínimo incluido en el ejemplo

QUESTIONS = {
    "args_grounded": Decider.noul(
        "Are the tool's argument values grounded in facts the user actually provided?",
        {"true": "every argument value traces back to something the user said",
         "false": "an argument value was guessed or invented, not stated by the user"},
    ),
    "premature": Decider.noul(
        "Is it premature to call this tool now, before clarifying with the user?",
        {"true": "the assistant should ask a clarifying question before calling the tool",
         "false": "there is nothing left to clarify; calling now is appropriate"},
    ),
}
YES = 0.45  # umbral ilustrativo: ajustalo con tu propio tráfico

class ToolCallReviewer(InterventionHandler):
    name = "strands-decider-tool-call-reviewer"

    def __init__(self, decider):
        self._decider = decider

    def before_tool_call(self, event, **kwargs):
        conversation = "\n".join(
            f"{m['role']}: {b['text']}"
            for m in event.agent.messages for b in m.get("content", []) if "text" in b
        )
        state = (f"--- CONVERSATION ---\n{conversation}\n\n"
                 f"--- PROPOSED TOOL CALL ---\ntool: {event.tool_use['name']}\n"
                 f"arguments: {json.dumps(event.tool_use.get('input') or {})}")
        answers = self._decider.ask(state, QUESTIONS)
        if answers["args_grounded"]["noul"] < YES:
            return Guide(feedback="The arguments look guessed. Ask the user to confirm them.")
        if answers["premature"]["noul"] >= YES:
            return Guide(feedback="It is too early to call this tool. Clarify with the user first.")
        return Proceed()

@tool
def get_weather(location: str) -> str:
    """Get the current weather for a specific city."""
    return f"It's 21C and sunny in {location}."

agent = Agent(
    model="us.anthropic.claude-haiku-4-5-20251001-v1:0",  # el LLM sigue en Amazon Bedrock
    tools=[get_weather],
    interventions=[ToolCallReviewer(Decider())],
)
print(agent("What's the weather?"))
Para correrlo tal cual está en el repo:
git clone https://github.com/strands-labs/strands-decider && cd strands-decider
pip install -e . strands-agents
strands-decider serve StrandsAgents/strands-decider-2B-qwen3.5-v1-2610 --port 8099
python examples/strands/tool_call_intervention.py
Lo interesante es Guide: no bloquea la llamada, le devuelve el turno al modelo con feedback, y el agente termina preguntando "¿de qué ciudad?" en lugar de contestar el clima de Seattle. Las acciones disponibles en las intervenciones de Strands son Proceed, Deny, Confirm (pide confirmación a una persona) y Guide, y hay ganchos equivalentes alrededor de la llamada al modelo y de la invocación completa.
4. Llevarlo a Amazon EKS como sidecar
Como el servidor escucha en 127.0.0.1, el patrón natural en Kubernetes es correrlo en el mismo pod que el agente: comparten red, el agente le habla a localhost y nada queda expuesto. Lo que sigue es un ejemplo mío, no un manifiesto oficial del proyecto (no hay imagen de contenedor publicada, así que necesitás construir una con pip install strands-decider y, idealmente, los pesos ya descargados).
apiVersion: apps/v1
kind: Deployment
metadata:
  name: agente-soporte
spec:
  replicas: 1
  selector:
    matchLabels: { app: agente-soporte }
  template:
    metadata:
      labels: { app: agente-soporte }
    spec:
      serviceAccountName: agente-soporte   # con Pod Identity para invocar Bedrock
      nodeSelector:
        node.kubernetes.io/instance-type: g6.xlarge
      initContainers:
        # Sidecar nativo (Kubernetes 1.29+): arranca antes que el agente y vive todo el pod
        - name: decider
          image: 111122223333.dkr.ecr.us-east-1.amazonaws.com/strands-decider:2610
          restartPolicy: Always
          command: ["strands-decider", "serve",
                    "StrandsAgents/strands-decider-2B-qwen3.5-v1-2610", "--port", "8099"]
          resources:
            limits: { nvidia.com/gpu: 1 }
          startupProbe:
            # httpGet no sirve: el kubelet pega a la IP del pod y el server solo escucha en 127.0.0.1
            exec:
              command: ["python", "-c",
                        "import urllib.request; urllib.request.urlopen('http://127.0.0.1:8099/health', timeout=5)"]
            periodSeconds: 10
            failureThreshold: 60
      containers:
        - name: agente
          image: 111122223333.dkr.ecr.us-east-1.amazonaws.com/agente-soporte:1.0.0
          env:
            - name: STRANDS_DECIDER_URL
              value: http://127.0.0.1:8099
Algunas notas de operación:
- Probes. Como dice el comentario, un
httpGetcontra el puerto del decider va a fallar siempre. Usáexeccontra127.0.0.1. - GPU. En EKS Auto Mode o con Karpenter, un NodePool para instancias con GPU (por ejemplo la familia g6, con NVIDIA L4 de 24 GB) alcanza de sobra para el modelo de 2B. Con nodos administrados, necesitás el NVIDIA device plugin.
- Pesos. Bajar el modelo de Hugging Face en cada arranque es lento y te ata a un servicio externo. Horneá los pesos en la imagen o montalos desde un volumen.
- Una request a la vez. El cliente del ejemplo es síncrono a propósito y aclara que la mejor forma de usar el servidor es de a una request por vez. Si muchas réplicas del agente comparten un decider, ese es el cuello de botella; con el patrón sidecar, cada pod tiene el suyo.
- Agrupá preguntas. El estado se codifica una vez por request: hacer ocho preguntas juntas cuesta mucho menos que ocho requests.
Trampas comunes
- Tratar la probabilidad como verdad. La calibración se ajustó sobre clasificación corta. El model card pide validar los umbrales con tu propio tráfico.
- Documentos largos. Es su punto débil declarado. Si tu estado son 10 páginas de contrato, recortá antes o usá un modelo más grande.
- Redacción de las preguntas. Preguntas distintas suelen recibir la misma respuesta; la redacción importa. Escribí bien las descripciones de cada opción (en
noul, las detrueyfalse): llevan buena parte de la señal. - Rúbricas raras.
scoreynoultransfieren peor a escalas o preguntas muy distintas de las del entrenamiento. - Idioma. Los ejemplos y datasets son en inglés. Si tu tráfico es en español, medí antes de confiar en los umbrales.
Precios
El modelo es gratis (Apache 2.0). Lo que pagás es la infraestructura donde lo corrés:
| Opción | Costo de referencia | Comentario |
|---|---|---|
| Laptop o PC del equipo | USD 0 | Ideal para experimentar y evaluar |
| EC2 g6.xlarge (NVIDIA L4, 24 GB), us-east-1 | ≈ USD 0,805 por hora (≈ USD 588 por mes encendida) | Precio on-demand; con Spot o Savings Plans baja bastante |
| Jev de TypeSafe AI (comparación) | USD 0,042 por millón de tokens de entrada | Servicio cerrado, acceso por lista de espera |
Una cuenta rápida y aproximada, hecha por mí con los números publicados: si una GPU atendiera decisiones de forma secuencial a unos 115 ms cada una, serían unas 8 por segundo, del orden de 20 millones por mes. Con estados de 500 tokens, esas mismas decisiones en un servicio cobrado por token como Jev rondarían los USD 450. Es decir: autohospedar conviene cuando tenés volumen sostenido o requisitos de privacidad; con poco volumen, la GPU ociosa sale más cara que pagar por token. Y comparado con verificar cada decisión con un LLM frontera, la diferencia está tanto en el costo como en la latencia.
Cómo bajar costos en la práctica:
- Empezá por CPU. El README muestra salidas generadas con
--device cpu. Para volúmenes chicos, medí la latencia en CPU antes de pagar una GPU. - Compartí la GPU. El modelo de 2B ocupa poco; la variante E4B está recomendada justamente para cuando la GPU se comparte con otro trabajo.
- Usá el decider como filtro. Que resuelva lo que tiene confianza alta y derive al LLM lo dudoso.
- Escalá a cero fuera de horario si tu agente es interno: con Karpenter el nodo GPU se va cuando no hay pods.
Disponibilidad y lo que conviene mirar con lupa
- ¿Está en sa-east-1? No hay región que valga: es software que corrés donde quieras. La pregunta real es si conseguís el hardware. Verificá con
aws ec2 describe-instance-type-offerings --region sa-east-1 --filters Name=instance-type,Values=g6.xlargeantes de diseñar; si no hay GPU disponible, la CPU es una opción para volúmenes bajos. - Residencia de datos. Es uno de sus mejores argumentos: la verificación se hace dentro de tu pod y la conversación no viaja a otro servicio para esa decisión. El LLM principal (por ejemplo en Bedrock) sigue teniendo sus propias consideraciones de región.
- Transferencia entre regiones. No aplica al decider en sí. Sí aplica la descarga inicial de pesos desde Hugging Face: espejalos en ECR o S3 en tu región.
- Madurez. Es un proyecto de Strands Labs, explícitamente experimental, sin usuarios en producción anunciados. El ritmo de versiones es alto (dos versiones nuevas del modelo de 2B y una familia sobre Gemma 4 desde el anuncio), así que fijá la versión exacta del modelo y del paquete.
- Seguridad del servidor. Sin autenticación y pensado para
localhost. No lo publiques en la red del clúster.
¿Vale la pena?
Como pieza para producción mañana, todavía no: es un experimento, el ejemplo oficial aclara que sus preguntas y umbrales son ilustrativos y no recomendaciones, y no hay casos de uso en producción publicados. Como idea para incorporar en el diseño de agentes, sí, y bastante. Si hoy tenés agentes que hacen llamadas al LLM solo para clasificar, rutear o validar, vale la pena correr el decider sobre una muestra de ese tráfico, comparar contra lo que decidió el LLM y ver cuánto coincide y con qué confianza.
Mi lectura: lo valioso de Strands Decider no es el benchmark, que con 231 tareas tiene bastante ruido, sino la separación que propone: el modelo clasifica y devuelve un número, tu código decide. Eso convierte decisiones que hoy están escondidas en prompts en algo que se puede testear, versionar y auditar, con umbrales explícitos en el código. Para quienes operamos plataformas, es la misma lógica que aplicamos con políticas de admisión en Kubernetes: un punto de control determinista antes de ejecutar algo. Que AWS lo publique abierto, con pesos y recetas de entrenamiento, mientras la alternativa que puso el tema en agenda es cerrada, también dice algo de cómo quiere posicionar a Strands. Lo pondría a prueba como guardarraíl de tool calls en un agente interno, en un pod con GPU compartida, y mediría antes de confiarle algo crítico.
Recursos
- Introducing Strands Decider 2B (blog de Strands Agents)
- Repositorio strands-labs/strands-decider (Apache 2.0)
- Ejemplo de intervención en un agente de Strands
- Model card de strands-decider-2B-hobson-v19 en Hugging Face
- Techstrong.ai: AWS explora los modelos de decisión
- VKTR: TypeSafe AI lanza Jev
- Desplegando.cloud: Strands Decider, la alternativa abierta a Jev
- En este blog: AWS Strands Agents, el framework que hace simple lo que antes era complejo