
El 30 de septiembre de 2026 AWS agregó pre-filtrado de metadata a Amazon S3 Vectors. Dicho así suena a un detalle de implementación, pero toca uno de los problemas más molestos de cualquier sistema de RAG en producción: le pedís al índice los 10 fragmentos más parecidos de un cliente en particular y te devuelve 3, o te devuelve 10 que no son los mejores. No hay error, no hay alarma; el modelo simplemente responde con menos contexto del que había disponible.
Con el cambio, S3 Vectors resuelve primero el filtro y recién después hace la búsqueda de similitud, solo sobre los vectores que pasaron. AWS habla de hasta 5 veces más vectores que cumplen el filtro cuando el filtro es selectivo. Además suma un operador de prefijo ($startsWith), sube a 100 las condiciones por consulta y no cobra nada extra. En este artículo vemos qué cambió exactamente, por qué el modo anterior perdía resultados, cómo probarlo sin tocar tu índice, cómo migrar y cómo queda un servicio de retrieval multi-tenant corriendo en Amazon EKS.
TL;DR
- Los índices de S3 Vectors ahora tienen dos modos:
CLASSIC(el filtro se evalúa en tándem con la búsqueda aproximada) yENHANCED(el filtro se resuelve antes de la búsqueda). - Con filtros selectivos (un tenant entre miles, una carpeta, un expediente)
ENHANCEDdevuelve hasta 5x más vectores que cumplen el filtro, según AWS. - Los buckets creados desde el 30/09/2026 usan
ENHANCEDy no se pueden pasar aCLASSIC. Los anteriores siguen enCLASSIChasta que los migres conUpdateIndexMode, sin reingestar nada. - Podés probar el comportamiento nuevo consulta por consulta con
queryMode=ENHANCEDantes de cambiar el índice. - Nuevo operador
$startsWithpara filtrar por prefijo de rutas o URLs, y un tope de 100 condiciones por consulta en índicesENHANCED(cada valor de un$incuenta como una). - Sin costo adicional: seguís pagando almacenamiento, PUT y consultas al precio normal de S3 Vectors.
- Disponible en todas las regiones comerciales donde está S3 Vectors, incluida São Paulo (sa-east-1).
Por qué ahora
S3 Vectors salió en preview en julio de 2025 y llegó a disponibilidad general en diciembre de ese año, con índices de hasta 2.000 millones de vectores e integración con Amazon Bedrock Knowledge Bases y Amazon OpenSearch. La propuesta siempre fue clara: almacenamiento vectorial barato y durable, con latencias de alrededor de 100 ms para consultas frecuentes, para cargas donde no hace falta una base vectorial siempre encendida. Lo cubrimos acá en el blog cuando salió y lo usamos en la guía de Knowledge Base con Crawl4AI y S3 Vectors.
El punto débil estaba en los filtros. Casi ningún RAG real busca sobre "todo": busca sobre los documentos de un cliente, de un área, de un idioma, de un período. En SaaS multi-tenant el filtro por tenant_id no es opcional, es parte del modelo de seguridad. Y cuanto más selectivo era el filtro, peor se comportaba el modo anterior.
Un artículo publicado en AWS re:Post lo midió con un millón de vectores sintéticos y 200 consultas: con un corpus separable, el recall@10 pasaba de 0,86 sin filtro a 0,83 con un filtro que dejaba el 10% del corpus, a 0,42 con el 1% y a 0,15 con el 0,01%. Su recomendación de entonces era partir los datos en índices separados por valores de baja cardinalidad (idioma, región, tenant), lo que recuperaba entre 15 y 31 puntos de recall a cambio de más índices que administrar. Es decir: el problema era conocido, medible, y la solución pasaba por rediseñar el esquema de datos. El pre-filtrado ataca la causa.
Qué es y qué no es
Qué es. Un nuevo modo de índice (ENHANCED) que cambia el orden de las operaciones al consultar: primero se identifican los vectores que cumplen la condición de metadata y después se calcula la similitud solo sobre ese subconjunto. Viene con un operador nuevo ($startsWith), un límite explícito de 100 condiciones por consulta y un parámetro por consulta (queryMode) para probarlo sin migrar.
Qué no es.
- No es una API nueva ni cambia
PutVectors: la metadata se carga igual que antes. - No hace falta reingestar: el cambio de modo es en el lugar.
- No convierte metadata no filtrable en filtrable. Lo que declaraste como no filtrable al crear el índice sigue sin poder usarse en filtros.
- No es búsqueda híbrida (léxica + semántica) ni re-ranking. Es la misma búsqueda de similitud, aplicada sobre un conjunto mejor delimitado.
- No es gratis en latencia en todos los casos: AWS documenta que con filtros amplios, índices grandes y muchas condiciones la consulta trabaja más. Más sobre esto abajo.
Cómo funciona: tándem contra pre-filtrado
La búsqueda en un índice vectorial grande es aproximada (ANN): en vez de comparar la consulta contra todos los vectores, el motor explora un vecindario de candidatos prometedores con un presupuesto acotado. Ahí está el problema del modo CLASSIC.
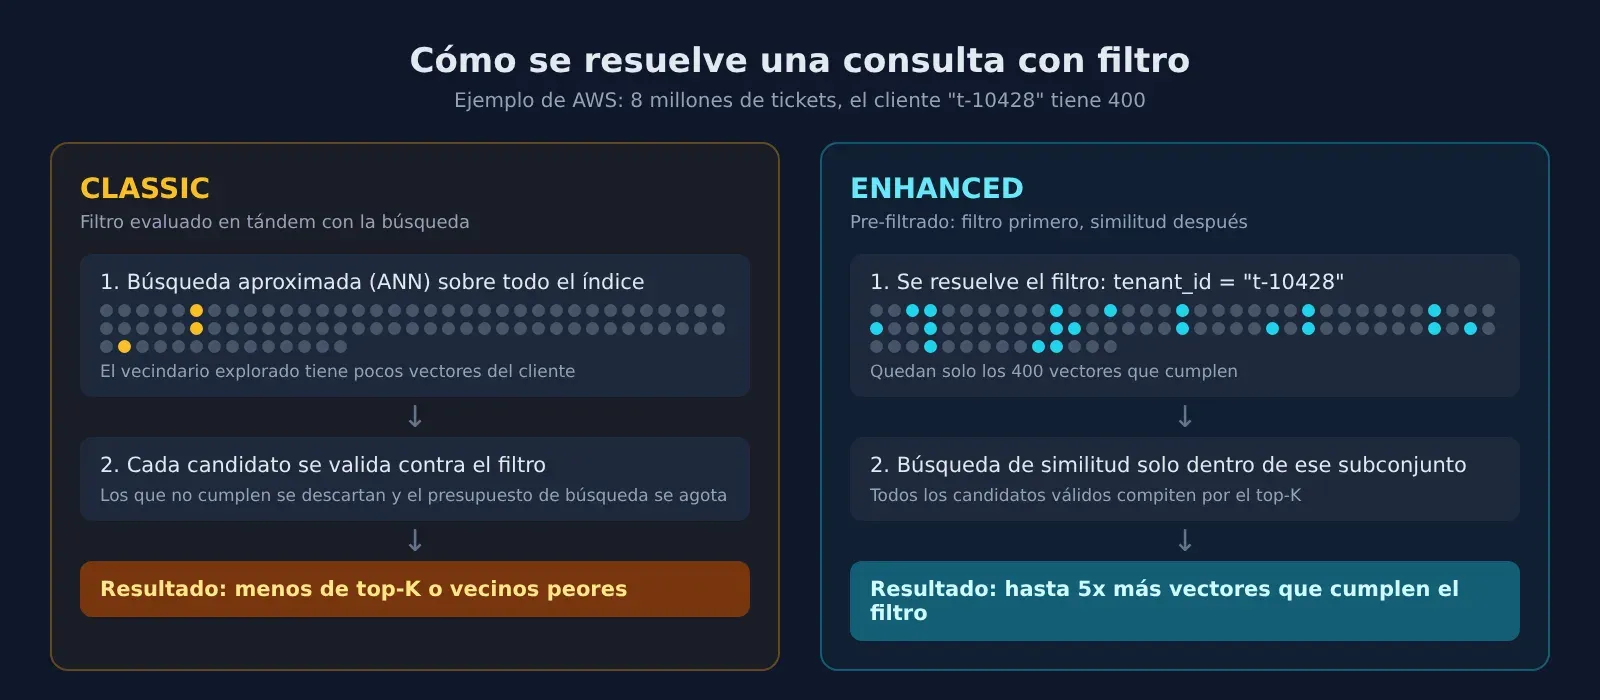
En CLASSIC, el filtro se valida mientras se buscan los K vecinos más cercanos. Si tu filtro deja pasar el 50% del corpus, no pasa nada: la mayoría de los candidatos explorados cumple. Pero si deja pasar el 0,005%, casi todo lo que el motor explora se descarta. El presupuesto se agota antes de juntar K resultados válidos y obtenés menos de K, o K resultados que no son los más cercanos dentro de lo que realmente cumplía el filtro. La documentación lo dice sin vueltas: en CLASSIC, una consulta filtrada puede devolver menos de K resultados si pocos vectores coinciden.
En ENHANCED, el orden se invierte. El ejemplo de AWS es claro: una base de 8 millones de tickets de soporte donde un cliente tiene 400. Con pre-filtrado, la búsqueda de similitud corre sobre esos 400, no sobre candidatos sacados de los 8 millones.
Un detalle práctico que se desprende de esto: la cantidad de resultados no es una señal de calidad. En CLASSIC podías recibir 10 resultados y que igual no fueran los mejores 10 del tenant. Si nunca mediste recall con filtros, no sabés cuánto estabas perdiendo.
Modos de índice: quién tiene qué
| Situación | Modo por defecto | ¿Se puede cambiar? |
|---|---|---|
| Índices en buckets creados desde el 30/09/2026 | ENHANCED |
No hay vuelta a CLASSIC |
| Índices en buckets creados antes del 30/09/2026 | CLASSIC |
Sí, a ENHANCED con UpdateIndexMode, y de vuelta a CLASSIC solo por CLI, SDK o API |
| Índices nuevos en un bucket viejo | Lo que diga el default del bucket | Se configura con PutVectorBucketDefaultIndexMode |
Algunas reglas finas que conviene tener presentes:
UpdateIndexModecambia solo ese índice. No toca el default del bucket ni otros índices.- En la consola el cambio a
ENHANCEDestá en el detalle del índice (Enable enhanced index mode), con un diálogo de confirmación. La vuelta aCLASSICno está en la consola. queryMode=ENHANCEDsobre un índiceCLASSICejecuta esa consulta con pre-filtrado. Sobre un índice que ya esENHANCEDno cambia nada, yqueryMode=CLASSICno se puede usar en índicesENHANCED.- El modo actual aparece en el campo
indexModede la respuesta deGetIndex.
Operadores de filtro y el límite de 100 condiciones
La sintaxis de filtros no cambió: JSON con operadores al estilo de MongoDB. La lista completa:
| Operador | Tipos | Qué hace |
|---|---|---|
$eq / $ne |
string, número, booleano | Igual / distinto. Con listas, $eq coincide si algún elemento coincide |
$gt, $gte, $lt, $lte |
número | Comparaciones numéricas |
$in / $nin |
lista | Coincide con alguno / con ninguno de los valores |
$exists |
booleano | Si el campo está presente |
$and / $or |
lista de filtros | Combinación lógica |
$startsWith |
string | Prefijo. Solo en ENHANCED (o con queryMode=ENHANCED) |
$startsWith resuelve un caso muy común: documentos organizados por ruta. Si guardás s3_path o document_id con una estructura jerárquica, podés pedir "todo lo que está bajo matter-4417/exhibits/" sin tener que duplicar la jerarquía en campos separados.
El límite de 100 condiciones por consulta aplica solo a índices ENHANCED, y se cuenta por valor, no por clave:
{"category": "electronics"}cuenta 1.{"region": {"$in": ["us-east-1", "us-west-2", "eu-west-1"]}}cuenta 3.{"$and": [{"category": "electronics"}, {"price": {"$lte": 500}}]}cuenta 2.
Si hoy armás filtros dinámicos con listas largas (por ejemplo, un $in con todos los proyectos a los que un usuario tiene acceso), revisalos antes de migrar: en un índice ENHANCED, una consulta con más de 100 condiciones devuelve un error de validación.
Metadata filtrable y no filtrable
El pre-filtrado solo opera sobre metadata filtrable, así que vale repasar los límites, que no cambiaron:
- Hasta 40 KB de metadata total por vector, de los cuales hasta 2 KB pueden ser filtrables.
- Hasta 50 claves de metadata por vector.
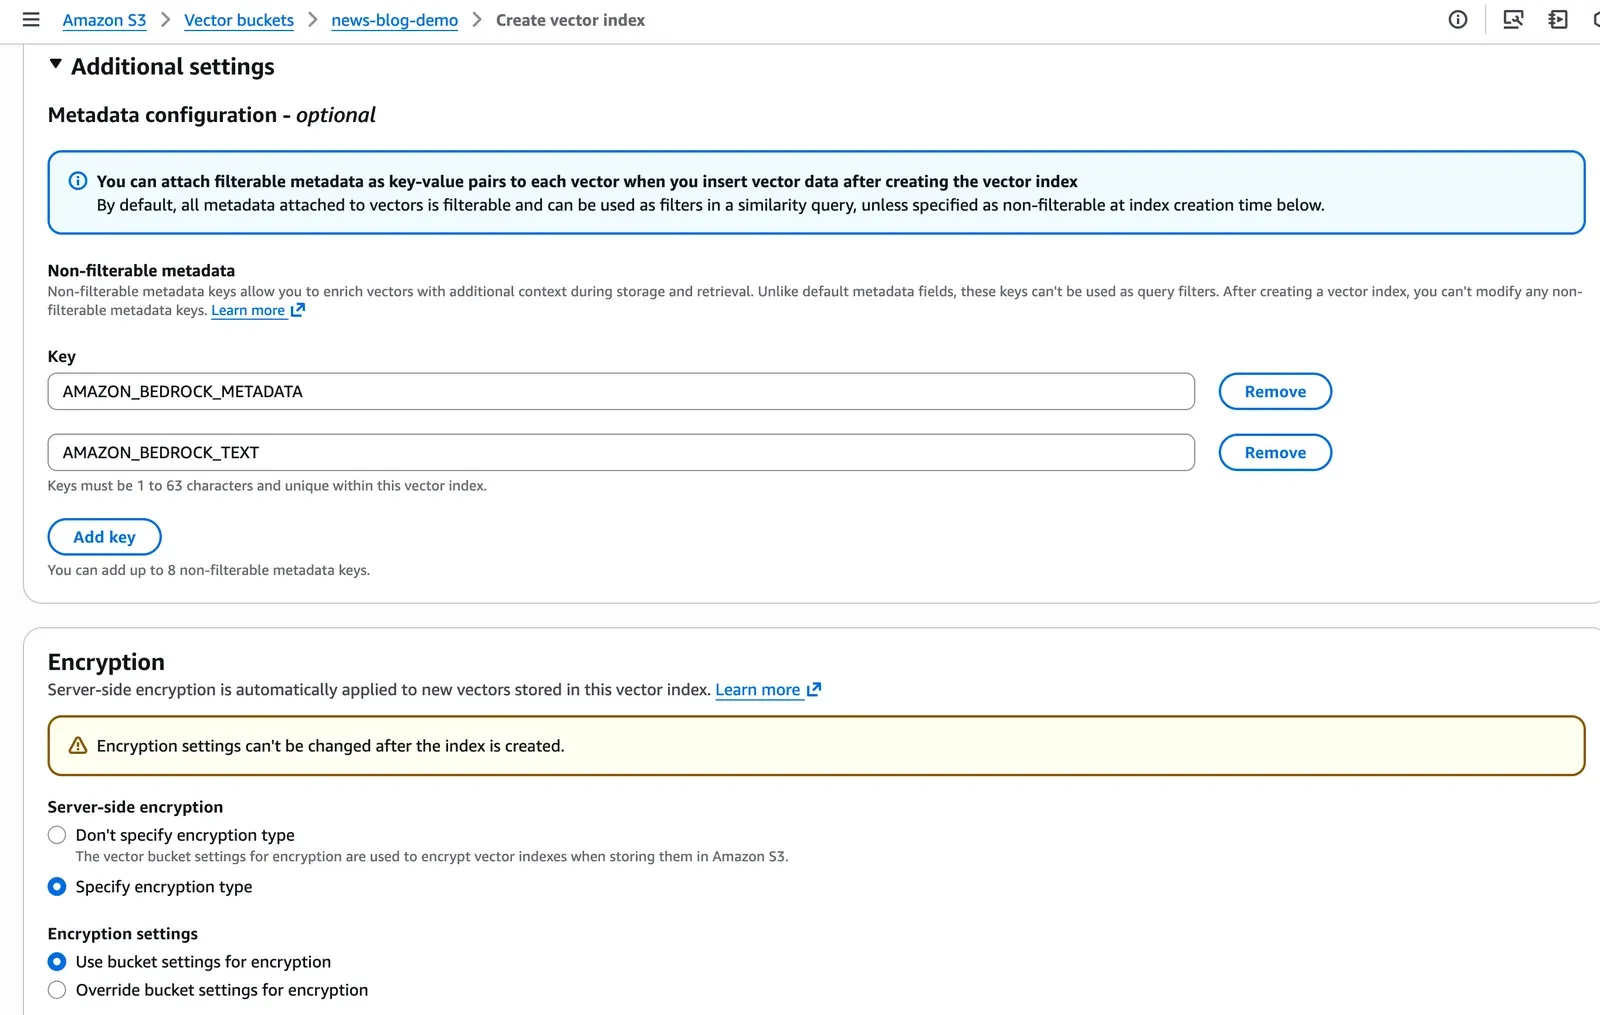
- Hasta 10 claves no filtrables por índice, que se definen al crear el índice y no se pueden modificar después.
La regla práctica: lo que usás para filtrar (tenant, categoría, fecha como número, flags, ruta) va como filtrable y corto. Lo que solo querés recuperar junto al resultado (el texto del chunk, un resumen, la URL original) va como no filtrable. Bedrock Knowledge Bases ya lo hace así: al crear el índice usa las claves no filtrables AMAZON_BEDROCK_TEXT y AMAZON_BEDROCK_METADATA.
Manos a la obra
Vamos a hacer tres cosas: medir cuánto recall estás perdiendo hoy, migrar el índice y dejar un servicio de retrieval multi-tenant en EKS con permisos mínimos. Necesitás una versión reciente de la AWS CLI y de boto3 (el parámetro queryMode y los comandos de modo de índice son nuevos).
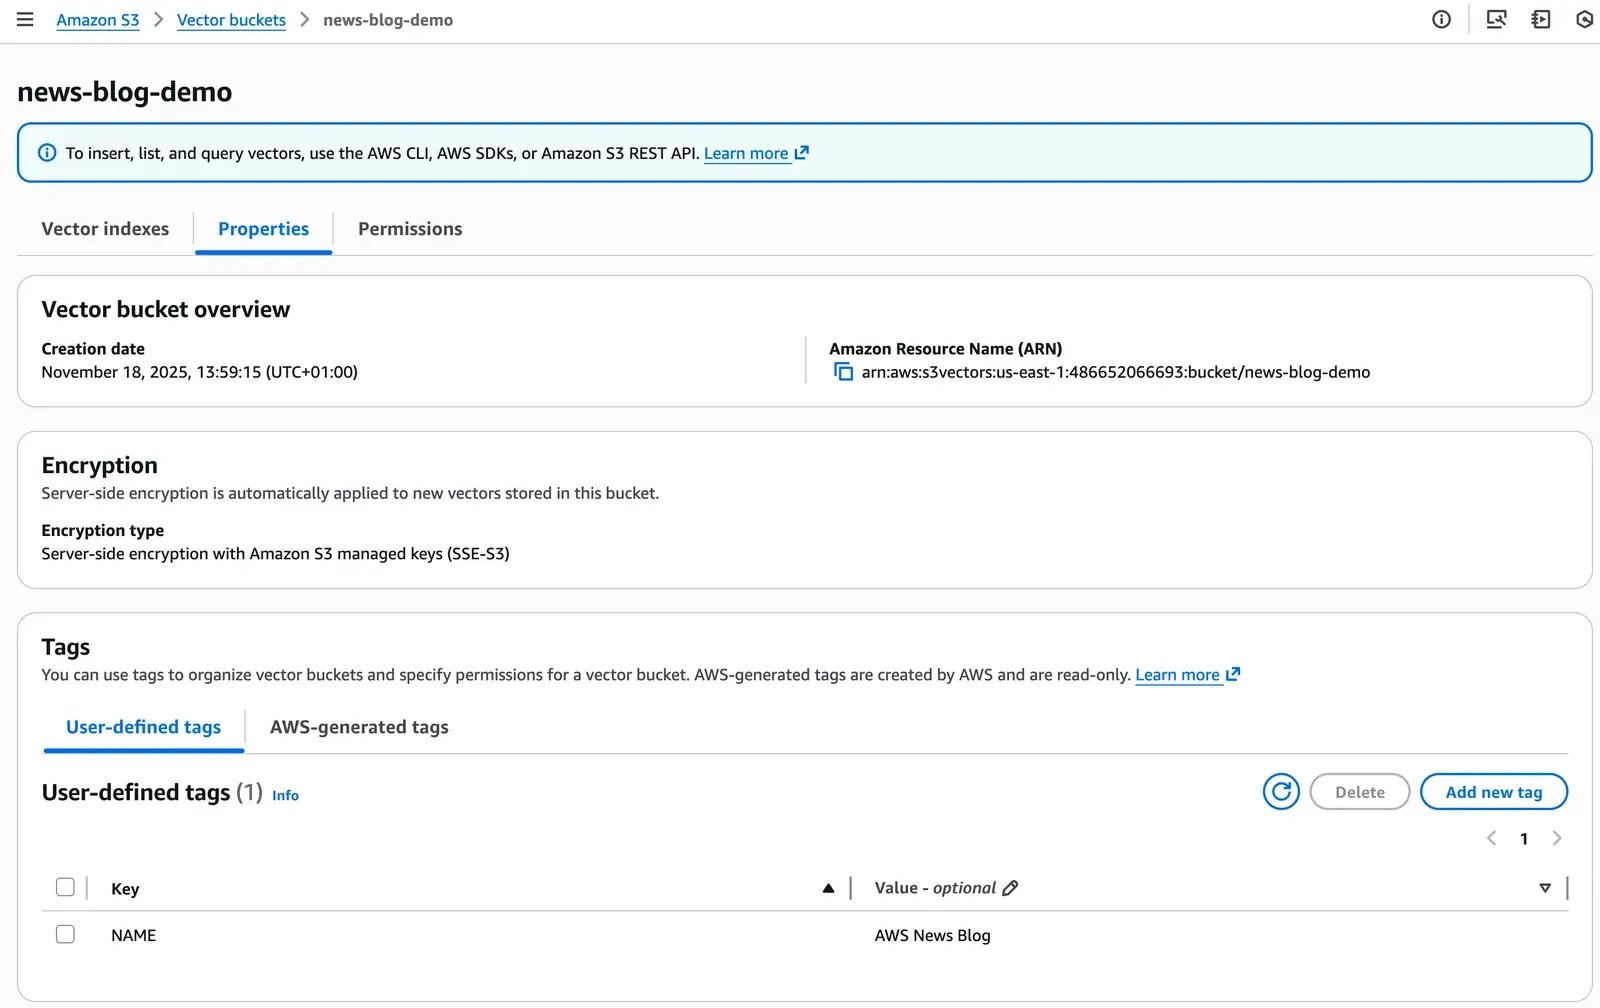
1. Revisar en qué modo está tu índice
aws s3vectors get-index \
  --vector-bucket-name my-vector-bucket \
  --index-name tickets \
  --query 'index.indexMode' --output text
Si responde CLASSIC, seguí con el paso 2 antes de tocar nada. Si responde ENHANCED, ya estás usando pre-filtrado.
2. Medir recall con y sin pre-filtrado
La idea: tomar un tenant chico, calcular por fuerza bruta cuáles son los K vecinos reales dentro de sus vectores, y comparar contra lo que devuelve el índice en cada modo. Para un índice de prueba de tamaño razonable alcanza con ListVectors y numpy (ojo: en índices grandes esto lee todo el índice y genera costo; hacelo sobre una copia o una muestra).
import boto3, json, numpy as np

BUCKET, INDEX, TENANT, K = "my-vector-bucket", "tickets", "t-10428", 10
s3v = boto3.client("s3vectors")
bedrock = boto3.client("bedrock-runtime")

def embed(text):
    body = json.dumps({"inputText": text, "dimensions": 1024, "normalize": True})
    r = bedrock.invoke_model(modelId="amazon.titan-embed-text-v2:0", body=body)
    return json.loads(r["body"].read())["embedding"]

# 1) Vectores del tenant (fuerza bruta, solo para la prueba)
keys, mat, token = [], [], None
while True:
    kw = dict(vectorBucketName=BUCKET, indexName=INDEX, maxResults=1000,
              returnData=True, returnMetadata=True)
    if token:
        kw["nextToken"] = token
    page = s3v.list_vectors(**kw)
    for v in page["vectors"]:
        if v.get("metadata", {}).get("tenant_id") == TENANT:
            keys.append(v["key"]); mat.append(v["data"]["float32"])
    token = page.get("nextToken")
    if not token:
        break
mat = np.array(mat)

def ground_truth(q):
    q = np.array(q)
    sims = mat @ q / (np.linalg.norm(mat, axis=1) * np.linalg.norm(q))
    return {keys[i] for i in np.argsort(-sims)[:K]}

def query(q, mode):
    r = s3v.query_vectors(vectorBucketName=BUCKET, indexName=INDEX,
                          queryVector={"float32": q}, topK=K,
                          filter={"tenant_id": TENANT}, queryMode=mode)
    return {v["key"] for v in r["vectors"]}

for text in ["no puedo iniciar sesión", "error al facturar", "cambio de plan"]:
    q = embed(text)
    gt = ground_truth(q)
    for mode in ("CLASSIC", "ENHANCED"):
        got = query(q, mode)
        print(f"{mode:9} {text[:24]:24} devueltos={len(got):2} recall@{K}={len(got & gt)/len(gt):.2f}")
Este script asume distancia coseno y embeddings de Titan Text Embeddings V2 con 1024 dimensiones; adaptalo a la métrica y al modelo de tu índice. Con un tenant que representa una fracción chica del índice deberías ver la diferencia; con un tenant enorme, probablemente no.
3. Migrar el índice y el default del bucket
# Pasar un índice existente a pre-filtrado (en el lugar, sin reingestar)
aws s3vectors update-index-mode \
  --vector-bucket-name my-vector-bucket \
  --index-name tickets \
  --index-mode ENHANCED

# Que los índices nuevos de este bucket nazcan en ENHANCED
aws s3vectors put-vector-bucket-default-index-mode \
  --vector-bucket-name my-vector-bucket \
  --default-index-mode ENHANCED
Si algo sale mal y el bucket es anterior al 30/09/2026, podés volver con --index-mode CLASSIC. Antes de migrar, buscá en tu código cualquier filtro que pueda superar las 100 condiciones.
4. Servicio de retrieval en EKS con Pod Identity
El patrón que queremos: el tenant_id sale del token del usuario (nunca de un parámetro que el cliente pueda manipular), la API arma el filtro y el pod consulta S3 Vectors con un rol que solo puede leer ese índice.
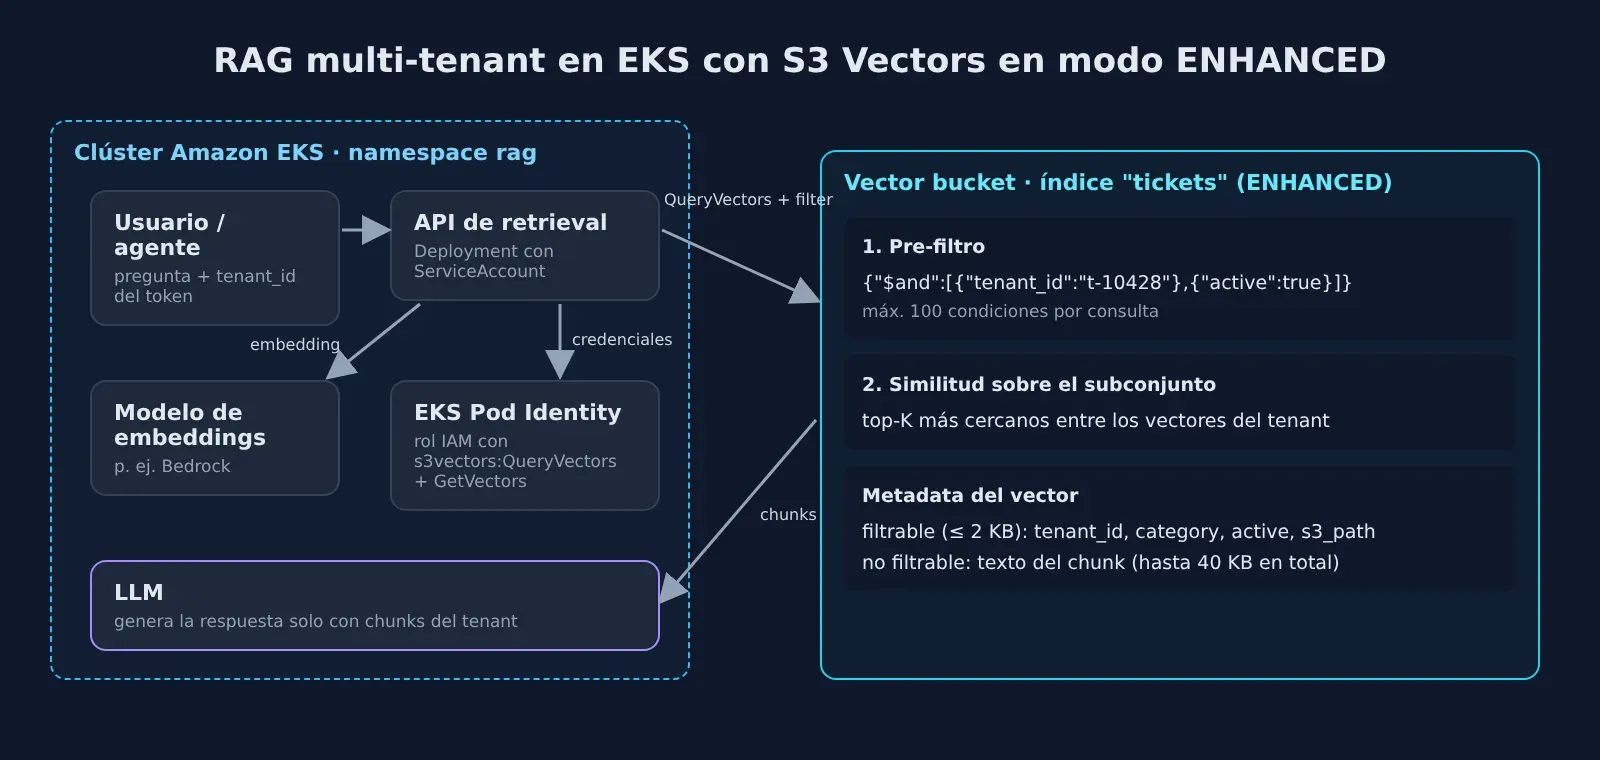
Primero, la política de IAM. Ojo con un detalle de permisos: s3vectors:QueryVectors solo alcanza si no usás filtros ni pedís metadata. Con filtros o returnMetadata=true también necesitás s3vectors:GetVectors; si falta, la consulta falla con 403. El segundo bloque es para generar embeddings con Bedrock; antes de copiarlo, verificá que el modelo esté disponible en tu región o cambiá la región del ARN.
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["s3vectors:QueryVectors", "s3vectors:GetVectors"],
      "Resource": "arn:aws:s3vectors:sa-east-1:111122223333:bucket/my-vector-bucket/index/tickets"
    },
    {
      "Effect": "Allow",
      "Action": "bedrock:InvokeModel",
      "Resource": "arn:aws:bedrock:sa-east-1::foundation-model/amazon.titan-embed-text-v2:0"
    }
  ]
}
El rol necesita una política de confianza para EKS Pod Identity (el clúster tiene que tener instalado el add-on eks-pod-identity-agent):
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": {"Service": "pods.eks.amazonaws.com"},
    "Action": ["sts:AssumeRole", "sts:TagSession"]
  }]
}
aws iam create-role --role-name rag-retrieval \
  --assume-role-policy-document file://trust.json
aws iam put-role-policy --role-name rag-retrieval \
  --policy-name s3vectors-read --policy-document file://policy.json

kubectl create namespace rag
kubectl -n rag create serviceaccount retrieval

aws eks create-pod-identity-association \
  --cluster-name my-cluster \
  --namespace rag \
  --service-account retrieval \
  --role-arn arn:aws:iam::111122223333:role/rag-retrieval
El Deployment no necesita nada especial más que usar ese ServiceAccount; el SDK toma las credenciales solo:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: retrieval
  namespace: rag
spec:
  replicas: 2
  selector:
    matchLabels: {app: retrieval}
  template:
    metadata:
      labels: {app: retrieval}
    spec:
      serviceAccountName: retrieval
      containers:
        - name: api
          image: 111122223333.dkr.ecr.sa-east-1.amazonaws.com/retrieval:1.0.0
          env:
            - {name: AWS_REGION, value: sa-east-1}
            - {name: VECTOR_BUCKET, value: my-vector-bucket}
            - {name: VECTOR_INDEX, value: tickets}
          ports:
            - containerPort: 8080
Y la función de búsqueda dentro de la API, con el tenant fijado del lado del servidor y un filtro de prefijo opcional:
import os, boto3

s3v = boto3.client("s3vectors")

def search(tenant_id: str, query_embedding: list[float], folder: str | None = None, k: int = 8):
    conds = [{"tenant_id": tenant_id}, {"active": True}]
    if folder:
        conds.append({"s3_path": {"$startsWith": folder}})
    r = s3v.query_vectors(
        vectorBucketName=os.environ["VECTOR_BUCKET"],
        indexName=os.environ["VECTOR_INDEX"],
        queryVector={"float32": query_embedding},
        topK=k,
        filter={"$and": conds},
        returnMetadata=True,
        returnDistance=True,
    )
    return r["vectors"]
Trampas comunes
- Pensar que el filtro por tenant es aislamiento. Es un filtro que arma tu código. Si un bug lo omite, la consulta ve todo el índice. Para tenants con requisitos fuertes de aislamiento, un índice por tenant (o un bucket) con permisos de IAM separados sigue siendo más seguro.
- Superar las 100 condiciones. Un
$incon 150 IDs de proyecto funciona enCLASSICy falla enENHANCED. - Usar
$startsWithen un índiceCLASSICsinqueryMode=ENHANCED: no está disponible. - Olvidar
s3vectors:GetVectors. Con filtros, sin ese permiso tenés 403. - Fechas como string. Las comparaciones
$gt/$ltson solo numéricas. Si querés filtrar por rango de fechas, guardá un epoch o un entero tipo20260930. - Asumir que un bucket nuevo admite
CLASSIC. Desde el 30/09/2026 los buckets nuevos son soloENHANCED. - No medir con filtros amplios. Si tu filtro deja pasar la mitad del índice, el pre-filtrado tiene más trabajo. Probá latencia con tus filtros reales antes de migrar índices grandes.
Precios
El pre-filtrado no tiene costo adicional ni cambia el modelo de precios. Estos son los precios de S3 Vectors en US East (N. Virginia), la región de referencia de la página de precios:
| Concepto | Precio (us-east-1) |
|---|---|
| Almacenamiento | USD 0,06 por GB-mes |
| PUT (datos lógicos subidos) | USD 0,20 por GB (mínimo 128 KB por PUT) |
| Consultas (API) | USD 2,50 por millón de consultas |
| Datos procesados por consulta | Por TB, con tramos según el tamaño del índice: USD 0,004 (primeros 100.000 vectores), USD 0,002 (de 100.000 a 10 millones), USD 0,0004 (más de 10 millones) |
| Datos devueltos | Los primeros 512 KB por consulta son gratis |
El ejemplo que publica AWS: 10 millones de vectores de 1.024 dimensiones repartidos en 40 índices de 250.000, con 1 KB de metadata filtrable y 1 KB de no filtrable por vector, un millón de consultas al mes con top 100 y una recarga completa cada seis meses. Total: USD 11,38 por mes (3,54 de almacenamiento, 1,97 de PUT, 3,37 de procesamiento y 2,50 de API).
Un detalle que surge de ese ejemplo: el procesamiento se calcula en función del tamaño del índice que consultás, no de cuántos vectores pasan el filtro. Un filtro muy selectivo mejora el recall, pero no abarata la consulta.
Cómo bajar costos en la práctica:
- Partí por índice cuando el filtro es fijo. Si un tenant grande siempre consulta solo lo suyo, un índice propio reduce los datos procesados y además te da aislamiento por IAM. El pre-filtrado es ideal para la cola larga de tenants chicos que no justifican un índice cada uno.
- Cuidá el tamaño de la metadata. Todo lo que guardás suma almacenamiento y PUT. El texto completo del chunk es lo que más pesa.
- Pedí el top-K que usás. Más resultados por consulta suman datos devueltos y contexto que el LLM tiene que procesar.
- Evitá recargas completas innecesarias. El PUT se cobra por GB subido; actualizá solo los vectores que cambian.
Para São Paulo y otras regiones, consultá los precios en la página de precios de S3: suelen ser más altos que en us-east-1.
Disponibilidad y lo que conviene mirar con lupa
- ¿Está en sa-east-1? Sí. S3 Vectors está disponible en São Paulo y el pre-filtrado llega a todas las regiones comerciales donde está el servicio, además de las regiones de China. AWS indicó que el despliegue terminaba en pocos días desde el anuncio; confirmá con
get-indexque tu índice aceptaENHANCED. - Residencia de datos. Los vectores y su metadata quedan en la región del bucket. El punto a revisar es el modelo de embeddings: si lo invocás en otra región o con un perfil de inferencia entre regiones de Bedrock, el texto que vectorizás se procesa fuera de la región del bucket.
- Transferencia entre regiones. Si tu clúster de EKS está en una región y el bucket en otra, cada consulta y cada resultado cruza regiones, con latencia y costo de transferencia. Mantené cómputo y vectores juntos.
- Bedrock Knowledge Bases. Las bases de conocimiento usan un índice de S3 Vectors por debajo. El anuncio no detalla cómo interactúan los filtros de
Retrievecon el modo del índice; si tu base de conocimiento se creó sobre un bucket anterior al 30/09/2026, revisá el modo del índice y medí antes de asumir mejoras. - Latencia con filtros amplios. AWS documenta que la latencia crece con el tamaño del índice, la amplitud del filtro y la cantidad de condiciones. Medí con datos representativos.
¿Vale la pena?
Si usás S3 Vectors con filtros, sí, y casi sin discusión: no cuesta más, no hay que reingestar y se puede probar consulta por consulta antes de cambiar nada. El único trabajo previo es revisar que ningún filtro supere las 100 condiciones y medir latencia si tus filtros son muy amplios.
Donde más se nota es en tres escenarios: SaaS multi-tenant con muchos clientes chicos en un mismo índice, colecciones organizadas por ruta (legales, documentación, repositorios) donde $startsWith ahorra campos duplicados, y agentes que filtran por sesión, usuario o ventana de tiempo, donde el subconjunto relevante es diminuto comparado con el índice.
Mi lectura: esto corrige una limitación que obligaba a diseñar alrededor del motor, no del problema. Hasta ahora la respuesta honesta a "¿puedo meter todos mis tenants en un índice?" era "sí, pero con los chicos vas a perder resultados", y la salida era multiplicar índices. Con pre-filtrado, el índice compartido pasa a ser una opción razonable para la cola larga, y el índice dedicado queda para los tenants grandes o los que necesitan aislamiento fuerte por IAM. Lo que no cambia: un filtro sigue siendo código tuyo, y en multi-tenant un filtro olvidado es una fuga de datos. Yo migraría los índices CLASSIC después de correr la prueba de recall del paso 2, y aprovecharía para auditar dónde se arma el filtro por tenant.
Recursos
- Anuncio: Amazon S3 Vectors introduces metadata pre-filtering (What's New)
- AWS News Blog: Amazon S3 Vectors now supports metadata pre-filtering for higher recall on filtered searches
- Documentación: Metadata filtering
- Documentación: Changing a vector index's mode
- API: UpdateIndexMode y QueryVectors
- Límites de S3 Vectors y regiones
- Precios de Amazon S3 (pestaña S3 Vectors)
- AWS News Blog: Amazon S3 Vectors now generally available
- AWS re:Post: How metadata filter selectivity affects recall in Amazon S3 Vectors
- Classmethod: prueba del pre-filtrado con 60.785 artículos (en japonés)