
El 24 de septiembre de 2026 AWS relanzó el custom event bus de Amazon EventBridge. No es una opción más dentro del bus de siempre: es un recurso nuevo, con otra API (eventsv2), otro modelo de permisos y otro modelo de precios. El bus que venías usando pasa a llamarse Custom event bus – classic y sigue funcionando igual.
Lo que cambia es el enfoque. Hasta ahora EventBridge era muy cómodo para enrutar eventos dentro de una cuenta, pero en organizaciones con decenas de cuentas terminabas armando una telaraña de buses, reglas de reenvío y resource policies, y cuando necesitabas orden estricto o volver a procesar eventos de la semana pasada, la respuesta solía ser "usá Kinesis, MSK o SQS FIFO". El bus nuevo apunta justo ahí: un único bus compartido con toda la organización, entrega ordenada por grupo, deduplicación, retención de hasta un año y replay desde cualquier punto.
En este artículo repaso qué trae, cómo se usa desde la CLI con ejemplos sacados de la documentación, cuánto cuesta con números reales (y cuándo sale más caro que el clásico) y qué conviene mirar si trabajás desde Sudamérica.
TL;DR
- Nuevo recurso custom event bus en EventBridge (API
eventsv2); el anterior queda como classic, sin cambios. - Un bus se comparte con cuentas, OU o toda la organización vía AWS RAM, con cuatro permisos administrados (publicar, suscribirse, conectar fuentes, todo). Cuota por defecto: 10.000 suscriptores por bus.
- Aparece el recurso Subscriber: filtro + transformación + un target + reintentos + DLQ en un solo objeto, creado y administrado por cada cuenta consumidora.
- Orden FIFO por
EventGroupId, deduplicación en una ventana de 5 minutos, retención de 1 a 365 días y replay eligiendo el punto de arranque de cada suscriptor. PutRawEventsacepta JSON, Avro, Protobuf o bytes crudos, con metadata propia; las transformaciones se escriben en JSONata.- Precio por volumen: US$ 0,18/GB de ingreso (0,12 después de 5.000 GB), US$ 0,05/GB de egreso por suscriptor, US$ 0,08/GB-mes de retención extra y US$ 0,15 por millón de evaluaciones.
- Disponible en 14 regiones. No está en São Paulo (sa-east-1).
Por qué ahora
Si armaste arquitecturas orientadas a eventos en AWS con varias cuentas, conocés el patrón: un bus central en la cuenta de plataforma, reglas que reenvían a buses en las cuentas de cada equipo, resource policies que alguien tiene que mantener, y un pedido de cambio al equipo de plataforma cada vez que un equipo nuevo quiere escuchar un tipo de evento. En 2025 EventBridge sumó entrega directa entre cuentas a targets como SQS o Lambda, que alivió parte del problema, pero el modelo seguía siendo el mismo: el dueño del bus escribe las reglas.
El otro dolor era la semántica. El bus clásico entrega con garantía de al menos una vez (at-least-once), sin orden y sin guardar los eventos salvo que configures un archive aparte. Para un flujo de pagos, de inventario o cualquier cosa donde "cancelado" no puede llegar antes que "creado", terminabas agregando SQS FIFO, Kinesis o Kafka en el medio. Dos tecnologías, dos modelos operativos, dos facturas.
El relanzamiento ataca las dos cosas a la vez: le da a cada equipo autonomía sobre sus suscripciones sin tocar el bus central, y le agrega al bus garantías que antes tenías que ir a buscar a otro servicio. No es casual que salga ahora: la cantidad de cuentas por organización no para de crecer (una cuenta por carga de trabajo y ambiente ya es lo normal) y los agentes de IA que reaccionan a eventos necesitan historial y orden para no actuar sobre un estado viejo.
Qué es y qué no es
Es un bus de eventos serverless administrado, con estado: guarda los eventos durante el período de retención que configures (1 día por defecto, hasta 365) y cada suscriptor lleva su propia posición de lectura. Se comparte entre cuentas con AWS RAM y cada cuenta consumidora crea, ve y paga sus propios suscriptores.
No es un reemplazo del bus clásico ni una migración automática. Tus buses actuales no se tocan, siguen con PutEvents, reglas y hasta cinco targets por regla. El bus nuevo convive con el clásico y hasta se pueden conectar entre sí: una regla del clásico puede tener como target un bus nuevo y un suscriptor del bus nuevo puede entregar a un bus clásico, en la misma región o en otra.
Tampoco es Kafka. Tiene orden por grupo y replay, pero no hay particiones que dimensionar, consumidores que hagan polling ni offsets que gestionar a mano: EventBridge empuja (push) los eventos a un target administrado. Si tu equipo necesita consumir con su propio código a su ritmo, el target natural va a seguir siendo una cola SQS o un stream de Kinesis detrás del suscriptor.
Para ubicarte rápido, esta es la comparación que publica la propia documentación:
| Capacidad | Custom event bus (nuevo) | Custom event bus – classic |
|---|---|---|
| Entre cuentas | Compartido con AWS RAM | Resource policy o reenvío a un bus de la otra cuenta |
| Retención | Incluida, 1 a 365 días | No guarda; necesitás un archive |
| Orden | FIFO por grupo de eventos | No disponible |
| Replay | Punto de arranque del suscriptor | Replay desde archive |
| APIs de publicación | PutEvents, PutRawEvents | PutEvents |
| Deduplicación | Por contenido o por clave | No disponible |
| Targets | 1 por suscriptor | Hasta 5 por regla |
Cómo funciona
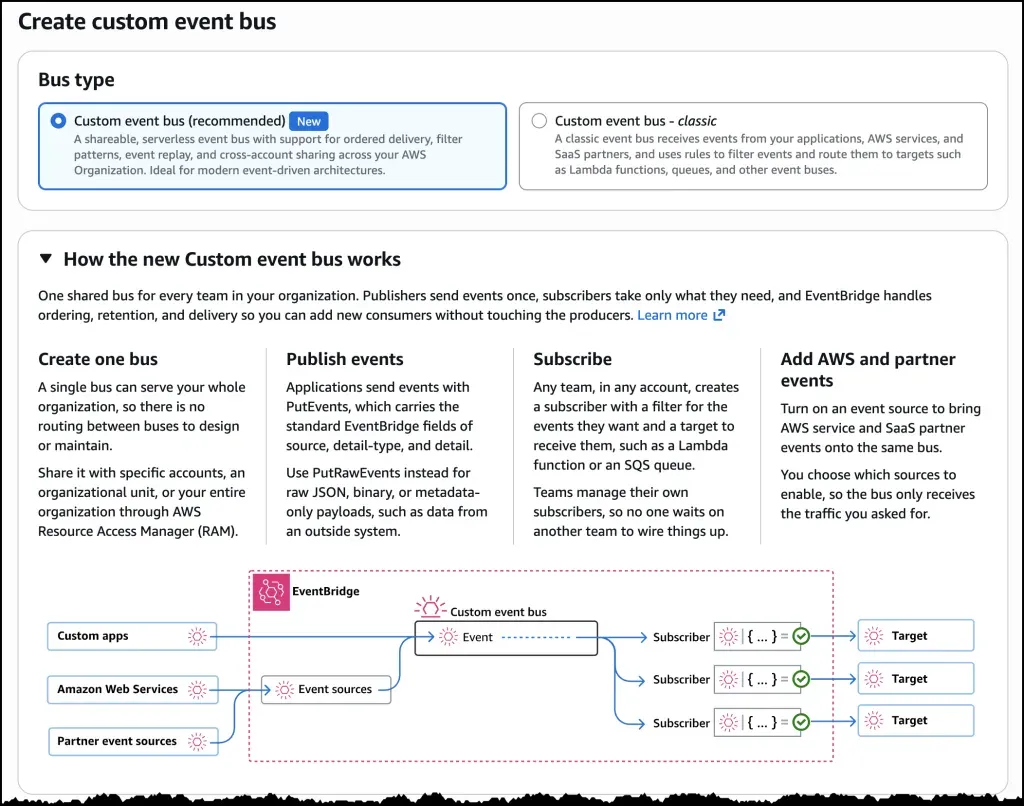
El modelo tiene tres recursos:
- Event bus: recibe los eventos, los enruta a los suscriptores que matchean y los guarda durante el período de retención. Su ARN cambia de forma (
arn:aws:events:<región>:<cuenta>:event-busv2/<nombre>/<id>) y la documentación recomienda guardar el ARN completo, no solo el nombre, porque el identificador es único aunque reutilices el nombre. - Subscriber: declara qué eventos quiere, opcionalmente los transforma y los entrega a exactamente un target. Si querés mandar lo mismo a tres lugares, creás tres suscriptores.
- Event source: conecta eventos de servicios de AWS o de partners SaaS al bus.
La diferencia de fondo con el clásico está en quién escribe el ruteo. Antes, el dueño del bus definía las reglas para todos. Ahora el equipo de plataforma crea el bus, lo comparte y se desentiende: cada equipo crea sus suscriptores en su propia cuenta, los ve solo a ellos cuando lista, y no puede modificar ni borrar el bus. El dueño sí ve todos los suscriptores y puede revocar cualquiera con RevokeResource.
Un bus para toda la organización
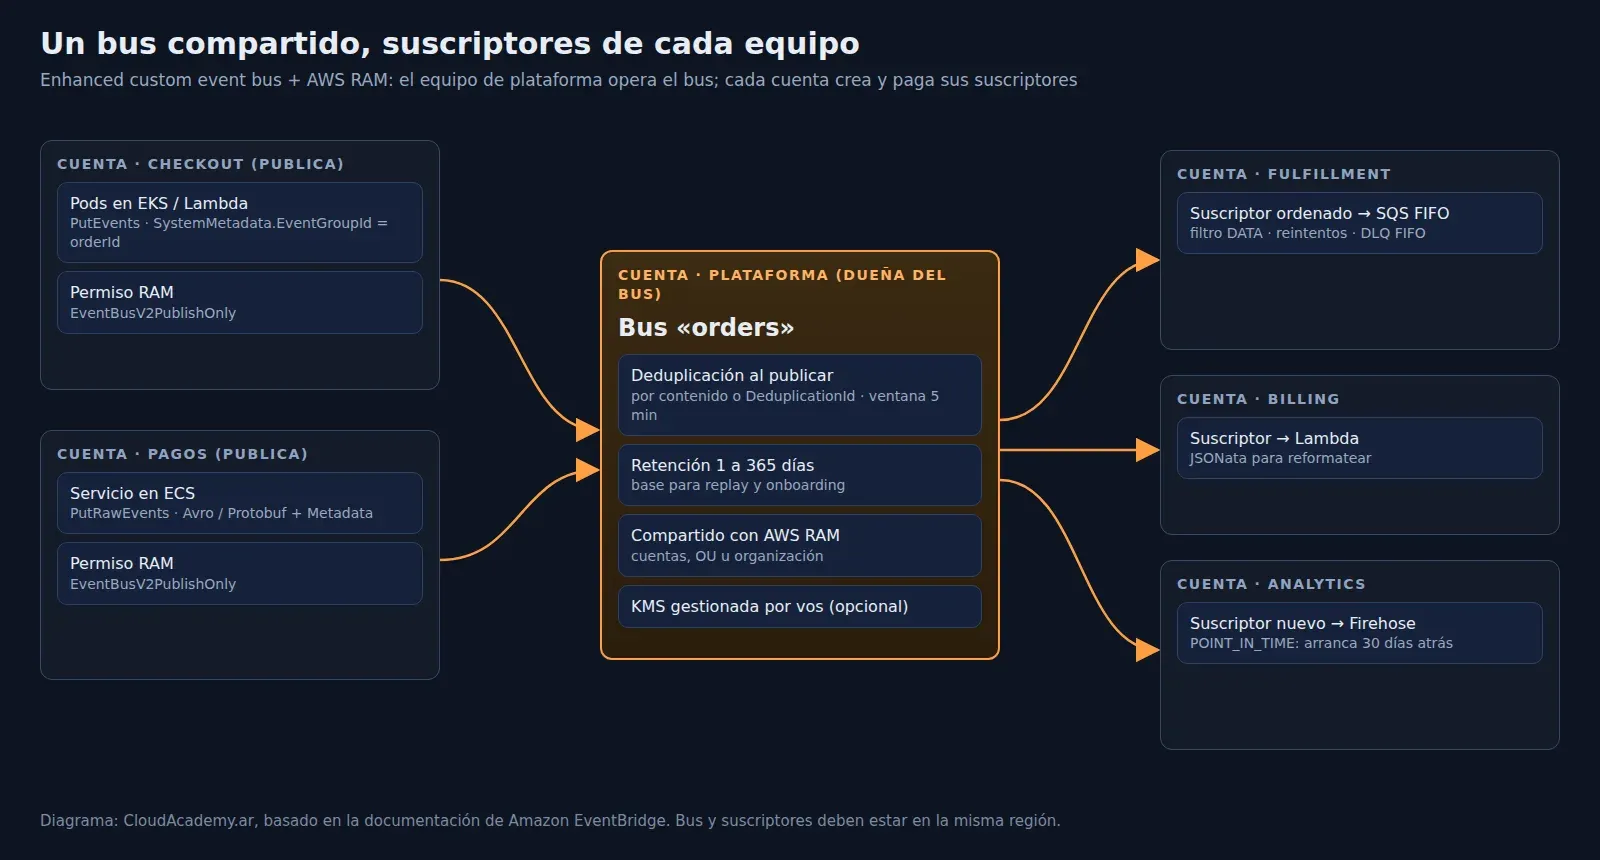
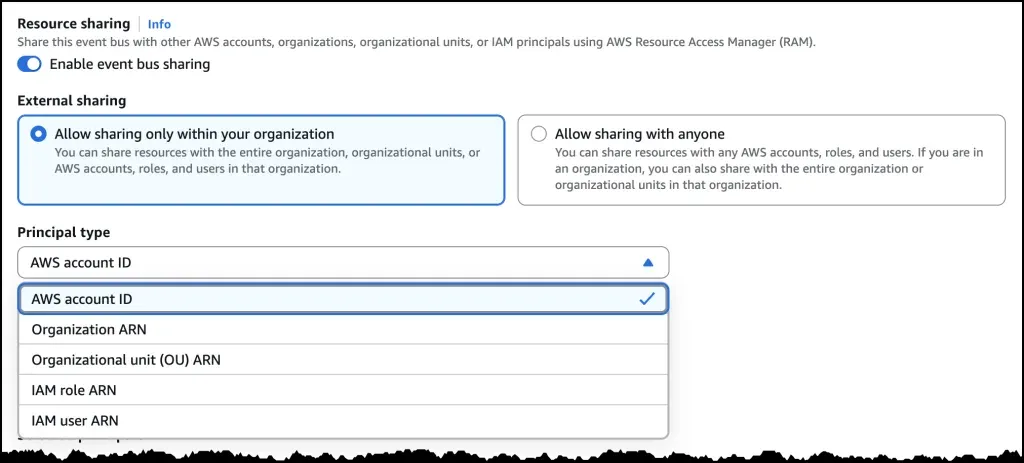
El bus se comparte con AWS RAM usando uno de cuatro permisos administrados:
| Permiso administrado de RAM | Qué puede hacer la cuenta consumidora |
|---|---|
AWSRAMEventBridgeEventBusV2PublishOnly | Publicar en el bus |
AWSRAMEventBridgeEventBusV2SubscribeOnly | Crear suscriptores sobre el bus |
AWSRAMEventBridgeEventBusV2EventSourceAccess | Conectar y actualizar event sources, describir el bus |
AWSRAMEventBridgeEventBusV2FullAccess | Todo lo anterior |
Podés compartir con IDs de cuenta, con una OU o con la organización entera (en ese caso tenés que habilitar el uso compartido con AWS Organizations en RAM). Las cuentas de fuera de la organización tienen que aceptar la invitación. Si preferís no usar RAM, también existe la vía de una resource policy propia, con un límite de 20 KB ajustable y rechazo explícito de políticas públicas.
Tres detalles que conviene tener presentes desde el diseño: la cuenta consumidora no puede volver a compartir el bus; el bus y los suscriptores tienen que estar en la misma región y partición; y compartir no tiene costo, pero el dueño puede ver métricas por consumidor (EventsDelivered y EgressBytes), lo que sirve para repartir costos o detectar quién está leyendo de más.
El suscriptor: filtro, transformación, target y fallas en un solo recurso
El suscriptor junta en un objeto lo que en el clásico estaba repartido entre regla, target, input transformer, política de reintentos y DLQ.
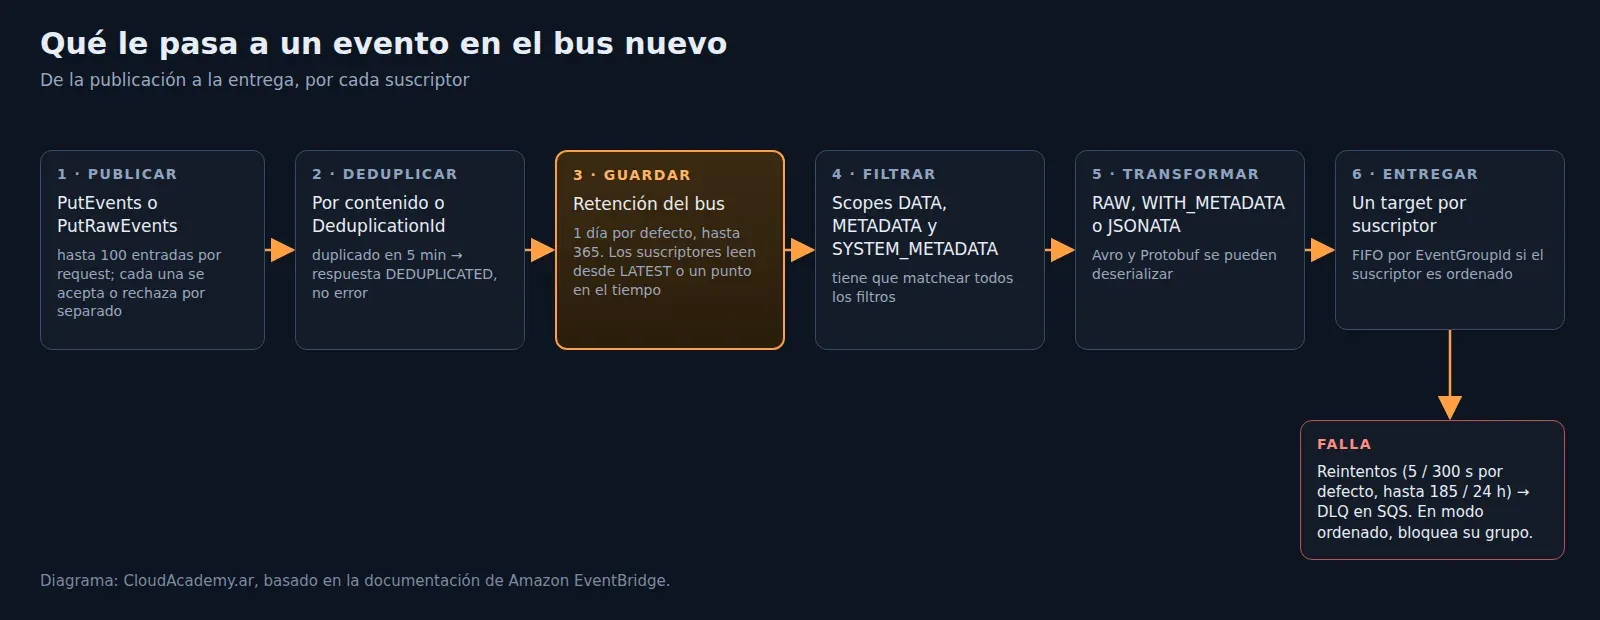
Filtros. Usan la sintaxis de event patterns de siempre, pero con tres alcances (scopes): DATA matchea el payload, METADATA matchea los pares clave-valor que el productor manda con PutRawEvents (solo igualdad exacta) y SYSTEM_METADATA matchea campos que pone EventBridge, como aws:Source o el EventGroupId. Hay como máximo un filtro por scope y el evento tiene que cumplir todos. Un suscriptor sin filtros recibe todo el bus.
Transformación. Tres modos: RAW (por defecto, solo el payload), WITH_METADATA (el evento completo con metadata) y JSONATA, donde escribís una expresión JSONata entre delimitadores {% %} y el evento está disponible como $events. La sintaxis se valida al crear el suscriptor, pero la evaluación ocurre en la entrega: una expresión que falla con datos reales hace fallar la entrega, no la creación.
Targets. SQS, Lambda, Kinesis Data Streams, Step Functions, SNS, endpoints HTTP o API destinations, Firehose, otro bus y los universal targets, que llaman directamente a una acción de la API de cualquier servicio con un ARN del estilo arn:aws:events:::aws-sdk:dynamodb:putItem. El anuncio habla de más de 250 servicios alcanzables por esta vía.
Reintentos y DLQ. Por defecto, 5 intentos dentro de 300 segundos. Se puede subir hasta 185 intentos y 86.400 segundos (24 horas); la entrega se corta con el primer límite que se alcance. La DLQ es una cola SQS que recibe un registro JSON con el código de error, la condición que agotó los reintentos y la lista de eventos fallidos con su eventGroupId.
Orden y deduplicación
Para pedir orden, el productor manda SystemMetadata.EventGroupId al publicar. Los suscriptores configurados para entrega ordenada reciben los eventos de un mismo grupo en secuencia (FIFO por grupo, por suscriptor); los demás suscriptores reciben los mismos eventos sin esa restricción. El caso típico es usar el ID del pedido, del cliente o de la cuenta como grupo: todo lo de un pedido llega en orden, y pedidos distintos se procesan en paralelo.
El orden tiene un precio que la documentación explica sin vueltas: un evento que falla bloquea a los siguientes de su grupo mientras se reintenta. Si dejás la política de reintentos en 24 horas, un evento envenenado puede frenar ese grupo durante un día entero. Para un flujo ordenado conviene una ventana de reintentos corta y una DLQ FIFO: EventBridge completa el MessageGroupId de cada registro con el EventGroupId, así que los fallidos de un grupo quedan en orden también en la DLQ.
La entrega síncrona es la otra mitad del orden. Con targets como Lambda o Step Functions Express se puede invocar en modo REQUEST_RESPONSE: EventBridge espera el resultado antes de dar el evento por procesado y pasar al siguiente del grupo. Ojo: una state machine Standard no soporta ese modo y devuelve SFN_TYPE_NOT_SUPPORTED.
La deduplicación ocurre al publicar, dentro de una ventana de 5 minutos. Podés mandar tu propia clave en SystemMetadata.DeduplicationId o dejar que EventBridge calcule un hash de las partes relevantes del evento. Un duplicado no es un error: la entrada vuelve con estado DEDUPLICATED en vez de PUBLISHED. El News Blog lo presenta como semántica de exactamente una vez; yo lo leería con más cuidado: deduplicás reintentos del productor dentro de esos 5 minutos, pero tu consumidor igual tiene que ser idempotente si reintenta la entrega.
Retención, replay y onboarding de consumidores nuevos
Cada bus define su retención (RetentionPeriodInDays, de 1 a 365) y cada suscriptor elige dónde arrancar:
LATEST: solo eventos publicados después de que existe el suscriptor.POINT_IN_TIMEconHORIZON: desde el evento más viejo que conserva el bus.POINT_IN_TIMEconTIMESTAMP: desde una fecha y hora concreta.
Esto cambia bastante la operación diaria. Un equipo de analytics que llega hoy puede empezar a leer desde hace 30 días sin pedirle nada a nadie. Si un bug en un consumidor procesó mal los eventos del martes, creás un suscriptor nuevo que arranque el martes a las 00:00 y reprocesás. Y si necesitás frenar un consumidor para una migración, lo pasás a STOPPED y al reanudarlo elegís entre LAST_PROCESSED (entrega todo lo acumulado) o LATEST (descarta el atraso).
Formatos: PutEvents y PutRawEvents
PutEvents sigue existiendo con el sobre (envelope) JSON clásico: Source, DetailType y Detail. La novedad es PutRawEvents, que recibe el payload como bytes en Data con un ContentType declarado (application/json, application/avro, application/protobuf u application/octet-stream) y hasta 100 claves de metadata propia. Sirve para publicar eventos en formatos abiertos como CloudEvents sin reenvolverlos, o para mover Avro y Protobuf con deserialización opcional vía schema registry.
Con bytes opacos (octet-stream) EventBridge no mira el payload: rutear solo se puede con METADATA o SYSTEM_METADATA. Un detalle que la documentación marca como error frecuente: los filtros dependen de qué API usó el productor. Un filtro escrito pensando en el sobre de PutEvents no matchea nada si el productor publica con PutRawEvents.
Manos a la obra
Vamos a armar el caso del diagrama: un bus orders en la cuenta de plataforma, compartido con la cuenta de fulfillment, un productor que publica con orden por pedido y un suscriptor con filtro y DLQ. Los comandos son los de la documentación oficial; reemplazá cuentas, región y ARNs por los tuyos. Necesitás una versión de la AWS CLI que ya incluya el namespace eventsv2.
1. Crear el bus con retención de 30 días y KMS propia
aws eventsv2 create-event-bus \
    --name orders \
    --description "Order events from the checkout service" \
    --storage-configuration RetentionPeriodInDays=30 \
    --encryption-configuration KmsKeyIdentifier=arn:aws:kms:us-east-1:111122223333:key/1234abcd-12ab-34cd-56ef-1234567890ab \
    --tags team=orders
El bus arranca en estado CREATING: mientras tanto no podés publicar ni crear suscriptores. Esperá a ACTIVE antes de seguir (en un pipeline, hacé polling con describe-event-bus). Si la clave KMS o su policy están mal, el bus queda en CREATE_FAILED y solo se puede borrar; el motivo aparece en StateReason.
aws eventsv2 describe-event-bus \
    --event-bus-arn arn:aws:events:us-east-1:111122223333:event-busv2/orders/EXAMPLE1234567890abcdef
2. Compartirlo con la cuenta del equipo consumidor
aws ram create-resource-share \
    --name orders-bus-share \
    --resource-arns arn:aws:events:us-east-1:111122223333:event-busv2/orders/EXAMPLE1234567890abcdef \
    --principals 444455556666 \
    --permission-arns arn:aws:ram::aws:permission/AWSRAMEventBridgeEventBusV2SubscribeOnly
Para compartir con toda la organización pasás el ARN de la organización o de una OU como principal. Para los productores, otro share con AWSRAMEventBridgeEventBusV2PublishOnly.
3. Publicar con orden por pedido
La forma mínima con PutEvents, tal como aparece en la documentación:
aws eventsv2 put-events \
    --event-bus-arn arn:aws:events:us-east-1:111122223333:event-busv2/orders/EXAMPLE1234567890abcdef \
    --entries '[
        {
            "Source": "com.example.orders",
            "DetailType": "OrderPlaced",
            "Detail": "{\"orderId\":\"1001\",\"total\":42.5}"
        }
    ]'
Para entrega ordenada y deduplicación agregás SystemMetadata.EventGroupId (por ejemplo, el ID del pedido) y, si querés controlar la clave, SystemMetadata.DeduplicationId. Si publicás desde pods en EKS, el patrón es el de siempre: EKS Pod Identity o IRSA con un rol cuya cuenta tenga el permiso de publicación compartido por RAM, y el SDK apuntando al ARN completo del bus. Dos cosas para no olvidar en el código: un request puede devolver 200 con entradas individuales rechazadas (revisá cada resultado, igual que en el clásico), y DEDUPLICATED es éxito, no lo trates como error ni lo reintentes.
4. Crear el suscriptor en la cuenta consumidora
Primero, el rol de entrega. Tiene que pertenecer a la cuenta del suscriptor, confiar en events.amazonaws.com y tener permiso sobre el target y sobre la DLQ. Quien crea el suscriptor necesita iam:PassRole.
{
    "Version": "2012-10-17",
    "Statement": [
        {
            "Effect": "Allow",
            "Principal": { "Service": "events.amazonaws.com" },
            "Action": "sts:AssumeRole"
        }
    ]
}
{
"Version": "2012-10-17",
"Statement": [
{
"Sid": "InvokeTheTarget",
"Effect": "Allow",
"Action": "sqs:SendMessage",
"Resource": "arn:aws:sqs:us-east-1:111122223333:large-orders"
},
{
"Sid": "WriteToTheDeadLetterQueue",
"Effect": "Allow",
"Action": "sqs:SendMessage",
"Resource": "arn:aws:sqs:us-east-1:111122223333:large-orders-dlq"
}
]
}Después, el suscriptor: pedidos de más de 500 a una cola, con DLQ.
aws eventsv2 create-subscriber \
    --name large-orders \
    --event-bus-arn arn:aws:events:us-east-1:111122223333:event-busv2/orders/EXAMPLE1234567890abcdef \
    --filter-configuration '{
        "Filters": [
            { "Scope": "DATA", "Pattern": "{\"detail\":{\"total\":[{\"numeric\":[\">\",500]}]}}" }
        ]
    }' \
    --invoke-configuration '{
        "TargetArn": "arn:aws:sqs:us-east-1:111122223333:large-orders",
        "RoleArn": "arn:aws:iam::111122223333:role/EventBusDeliveryRole"
    }' \
    --on-failure-configuration '{ "Arn": "arn:aws:sqs:us-east-1:111122223333:large-orders-dlq" }'
EventBridge procesa una sola creación o borrado de suscriptor por vez en cada bus. Si tu IaC crea varios en paralelo sobre el mismo bus, vas a ver ConcurrentModificationException: reintentá, o serializá esos recursos en el despliegue.
5. Reprocesar desde una fecha
aws eventsv2 create-subscriber \
    --name reprocess-september \
    --event-bus-arn arn:aws:events:us-east-1:111122223333:event-busv2/orders/EXAMPLE1234567890abcdef \
    --starting-position POINT_IN_TIME \
    --point-in-time-configuration '{ "PointType": "TIMESTAMP", "StartingPoint": "2026-09-01T00:00:00Z" }' \
    --invoke-configuration '{
        "TargetArn": "arn:aws:sqs:us-east-1:111122223333:reprocess",
        "RoleArn": "arn:aws:iam::111122223333:role/EventBusDeliveryRole"
    }'
6. Pausar y reanudar
# Pausar
aws eventsv2 update-subscriber \
    --subscriber-arn arn:aws:events:us-east-1:111122223333:subscriber/large-orders/EXAMPLEabcdef1234567890 \
    --state STOPPED

# Reanudar entregando lo acumulado
aws eventsv2 update-subscriber \
    --subscriber-arn arn:aws:events:us-east-1:111122223333:subscriber/large-orders/EXAMPLEabcdef1234567890 \
    --state RUNNING \
    --resume-position LAST_PROCESSED
Trampas comunes
Cuando publicás, recibís 200 y al target no llega nada, la documentación lista las causas en orden de frecuencia. Te las dejo con cómo detectarlas:
- La entrega se sigue reintentando. Con reintentos largos, el evento puede estar "en vuelo" varios minutos.
- El suscriptor está
STOPPEDo fue revocado.describe-subscribertiene que mostrarState: RUNNINGy no tenerRevoked. - El suscriptor arrancó en
LATESTy el evento se publicó antes de que existiera. - El filtro se escribió para la otra API de publicación (
PutEventscontraPutRawEvents) y no matchea nada. - El rol de entrega no llega al target o a la DLQ.
Las métricas viven en el namespace AWS/EventsV2 y se leen como un embudo: si FilterEvaluated está en 0, no llegan eventos; si FilterMatched está en 0, el filtro no matchea; si hay matches pero EventsDelivered está en 0, falla la entrega (mirá EventsDropped, OnFailureDestinationDelivered y OnFailureDestinationFailed). Un truco útil que sugiere la propia AWS: un suscriptor de diagnóstico sin filtro, con WITH_METADATA, apuntando a una cola, para ver la forma real de los eventos. Y si hace falta más detalle, logs con LogConfiguration.Level en INFO e IncludePayload en FULL (cuidado con datos sensibles en el payload).
Una más, para targets FIFO: el ID de deduplicación del target (por ejemplo, SqsParameters.MessageDeduplicationId) tiene que ser un valor por mensaje derivado con JSONata. Si ponés una constante, SQS descarta todo después del primer mensaje.
Precios
El cambio de modelo es probablemente lo más importante para decidir. El clásico cobra por evento; el nuevo, por volumen de datos, y separa lo que paga quien publica (ingreso) de lo que paga quien consume (egreso). Precios de la página oficial de EventBridge, que no indica diferencias por región:
| Dimensión | Precio | Quién lo paga |
|---|---|---|
| Ingreso (primeros 5.000 GB/mes) | US$ 0,18 por GB | Cuenta que publica |
| Ingreso (después de 5.000 GB/mes) | US$ 0,12 por GB | Cuenta que publica |
| Egreso | US$ 0,05 por GB, por suscriptor | Cuenta del suscriptor |
| Almacenamiento (retención más allá de 1 día) | US$ 0,08 por GB-mes | Dueño del bus |
| Evaluación (deduplicación, transformaciones, validación de esquema) | US$ 0,15 por millón de eventos (en bloques de 64 KB) | Según quién la use |
Cada evento se redondea hacia arriba al KB más cercano. No hay cargo mínimo ni costo por compartir.
El ejemplo oficial. AWS publica este caso: 1.000 eventos por segundo de 2 KB en promedio, 2 suscriptores, transformación JSONata y validación de esquema, retención de 7 días y 1% de fallas con los 3 reintentos por defecto. Resultado: US$ 922 de ingreso, US$ 518 de egreso, US$ 16 de egreso por reintentos, US$ 778 de evaluación y US$ 83 de almacenamiento, US$ 2.317 por mes. Rehice las cuentas (30 días, 2.592 millones de eventos, 5.184 GB) y cierran.
La comparación que no está en el anuncio. El clásico cobra US$ 1 por millón de eventos publicados (en bloques de 64 KB), la entrega dentro de la misma cuenta es gratis y la entrega a otra cuenta cuesta US$ 1 por millón. Con ese mismo volumen de 2.592 millones de eventos al mes:
| Escenario (1.000 ev/s, 30 días, 2 suscriptores) | Bus nuevo (ingreso + egreso) | Clásico |
|---|---|---|
| Eventos de 1 KB | ~US$ 726 | US$ 2.592 (misma cuenta) / US$ 7.776 (2 entregas a otras cuentas) |
| Eventos de 2 KB | ~US$ 1.440 | US$ 2.592 / US$ 7.776 |
| Eventos de 10 KB | ~US$ 6.002 | US$ 2.592 / US$ 7.776 |
| Eventos de 60 KB | ~US$ 34.514 | US$ 2.592 / US$ 7.776 |
Cálculo propio con los precios publicados, sin retención extra, reintentos ni evaluación, y sin contar archive en el clásico. La conclusión es clara: con eventos chicos y entrega entre cuentas, el bus nuevo sale bastante más barato; con eventos grandes, puede salir varias veces más caro, porque el clásico cobra lo mismo por un evento de 1 KB que por uno de 64 KB. El punto de equilibrio contra el clásico dentro de una misma cuenta está alrededor de los 4 KB por evento con dos suscriptores.
Cómo bajar costos en la práctica:
- Adelgazá los eventos. Publicá identificadores y lo necesario para rutear; el detalle pesado va a S3 o a la base (patrón claim check). Acá cada KB se paga en el ingreso y otra vez por cada suscriptor.
- Usá formatos binarios. Avro o Protobuf vía
PutRawEventspesan bastante menos que el mismo contenido en JSON. - No abuses de la evaluación. En el ejemplo oficial es un tercio de la factura. Si una transformación se puede hacer gratis en la Lambda del consumidor, quizás no valga la pena pagarla en el bus.
- Dimensioná la retención. El primer día está incluido; a 1.000 ev/s de 2 KB, cada día extra son unos 173 GB-mes adicionales. Treinta días "por las dudas" suman.
- Consolidá suscriptores. Cada uno paga egreso sobre lo que matchea. Dos suscriptores que leen lo mismo para terminar en el mismo lugar son plata tirada.
- Repartí costos con las métricas por consumidor (
EgressBytes) en vez de adivinar.
Disponibilidad y lo que conviene mirar con lupa
El bus nuevo está disponible en 14 regiones: US East (N. Virginia y Ohio), US West (Oregon), Europa (Irlanda, Frankfurt, Estocolmo y España) y Asia Pacífico (Hong Kong, Malasia, Mumbai, Singapur, Sídney, Tailandia y Tokio). Se crea desde la consola, la CLI, los SDK y CloudFormation.
¿Está en São Paulo (sa-east-1)? No. Y como el bus y sus suscriptores tienen que estar en la misma región, si tus cargas de trabajo corren en sa-east-1 hoy no podés usarlo de forma local.
Residencia de datos. El bus nuevo guarda eventos (esa es la gracia de la retención). Si tus eventos llevan datos personales o financieros sujetos a requisitos de residencia en la región, llevarlos a us-east-1 para usar el bus nuevo no es solo una decisión técnica: consultalo con quien corresponda antes. Sumá cifrado con tu propia clave KMS y revisá qué tenés en los logs si activás IncludePayload.
Transferencia entre regiones. Técnicamente se puede puentear: una regla de un bus clásico en sa-east-1 puede tener como target un bus nuevo en us-east-1, y un suscriptor puede entregar a un bus en otra región. Pero eso suma latencia, una dependencia de otra región y costo de transferencia de datos entre regiones, además del ingreso por GB del bus nuevo. Tiene sentido si tu plataforma de eventos ya está en Virginia u Ohio; para una arquitectura toda en São Paulo, yo esperaría.
Otros puntos: el ARN y la API son distintos (eventsv2, event-busv2), así que las policies de IAM, SCP y módulos de Terraform o CDK que tengas para el clásico no aplican tal cual; y la detección de loops entre buses es de mejor esfuerzo, la documentación pide explícitamente no depender de ella.
¿Vale la pena?
Sí, si tenés una organización con muchas cuentas y un equipo de plataforma cansado de ser el cuello de botella de cada suscripción nueva; si hoy mantenés SQS FIFO o Kinesis en el medio solo para garantizar orden o poder reprocesar; o si tus eventos son chicos y cruzan cuentas, donde el modelo por GB te baja la factura.
Todavía no, si tus cargas corren en sa-east-1; si tus eventos son pesados (decenas de KB) y no podés adelgazarlos; o si lo que tenés con el clásico funciona dentro de una sola cuenta y no necesitás orden ni replay. Tampoco reemplaza a Kafka o Kinesis cuando necesitás consumo por pull, throughput sostenido muy alto con particionado propio o un ecosistema de conectores.
Mi lectura: es el cambio más grande de EventBridge desde que existe, y lo más valioso no es el orden sino el modelo de propiedad. Que cada equipo cree y pague sus suscriptores sobre un bus que no le pertenece es lo que faltaba para que un bus central sea algo que la plataforma opera y no algo que la plataforma atiende por ticket. La retención con replay por suscriptor es el segundo gran cambio: te saca de encima los archives y el "no podemos reprocesar". Lo que miraría con lupa antes de migrar es el precio con tus tamaños de evento reales, el bloqueo por grupo cuando falla un evento en modo ordenado, y la falta de sa-east-1. Mi recomendación: empezá con un dominio nuevo o uno que hoy sufre por orden o replay, medí el tamaño medio de los eventos y dejá el resto en el clásico, que no se va a ningún lado.
Recursos
- AWS News Blog: Introducing enhanced custom event buses in Amazon EventBridge
- What's New: Amazon EventBridge relaunches event buses for enterprise scale
- Documentación: What is the EventBridge Custom Event Bus?
- Publicar eventos (PutEvents y PutRawEvents)
- Suscriptores: filtros, transformaciones, targets y troubleshooting
- Reintentos, DLQ y entrega ordenada
- Replay y puntos de arranque
- Compartir el bus con otras cuentas
- Precios de Amazon EventBridge